Blog

  • dBDSP Audio – Neural Outboard: Rode capturas NAM A2 de equipamentos analógicos

    dBDSP Audio – Neural Outboard: Rode capturas NAM A2 de equipamentos analógicos

    O NeuralOutboard, da dbdsp audio, é um plugin de coloração analógica que roda capturas NAM de equipamentos reais, como pré-amplificadores, compressores, máquinas de fita e canais de console, dentro da sua DAW. Neste guia você vai entender como funcionam o ganho de entrada, o Drive, o Morph entre capturas, o oversampling e a nova aceleração por GPU, além das limitações do plugin. Assista ao vídeo abaixo e depois siga a leitura com os detalhes de cada controle.

    O que é o NeuralOutboard

    O NeuralOutboard é um processador de coloração analógica e saturação para mixagem e masterização, da dbdsp audio. A diferença em relação a praticamente tudo que você já usou está na premissa: em vez de modelar um circuito fixo, ele não modela circuito nenhum. Ele carrega capturas NAM — modelos neurais de equipamento real, treinados com o Neural Amp Modeler — e roda o áudio através delas.

    Pré-amplificadores, compressores, máquinas de fita, equalizadores, canais de console. Você joga a captura no slot, empurra o nível, e recebe o caráter harmônico, a compressão e a curva de equalização daquela unidade específica. Serve para uma faixa isolada, um barramento de bateria ou o mix inteiro.

    A versão 3.2 trouxe duas mudanças que alteram o que é praticável no dia a dia: aceleração por placa de vídeo e os NAM Sets. Vamos chegar nas duas.

    Captura neural e modelagem física: duas filosofias opostas

    Antes de entrar nos controles, vale entender o que diferencia essa abordagem da emulação tradicional, porque isso explica tanto as forças quanto os limites do plugin.

    Modelagem física parte do circuito. Alguém estuda o esquemático, identifica a válvula, o transformador, o diodo, o capacitor, e escreve equações que descrevem o comportamento de cada componente. O plugin resolve essas equações em tempo real. Existe um modelo do mecanismo.

    Captura neural parte do som. Um sinal de teste conhecido passa pelo hardware real, a saída é gravada, e uma rede neural é treinada até produzir a mesma saída para a mesma entrada. Ninguém precisa saber o que existe dentro do equipamento. É modelagem de caixa-preta: a rede aprende o mapeamento entrada→saída sem nenhuma noção de circuito.

    Isso gera uma divergência prática importante. Na modelagem física, todo botão do hardware existe no plugin, porque o modelo entende o que aquele botão faz no circuito — você gira o ganho livremente e a resposta acompanha. Na captura, o modelo é o retrato de um único estado do equipamento. Se a captura foi feita com o ganho às nove horas, aquilo é tudo que existe naquele arquivo.

    Em compensação, a captura não depende de ninguém ter estudado o esquemático. Qualquer unidade, por mais obscura ou rara, vira modelo em algumas horas. É essa a troca.

    O fluxo de sinal

    O painel foi desenhado para ser lido de cima para baixo, e a ordem visual corresponde à ordem do processamento:

    Trim de entrada → Roteamento → Drive → Modelo → Oversampling → Mid/Side → Dry/Wet → Saída

    Com bloqueio de DC e medição completa de entrada e saída ao longo do caminho. Quem já se perdeu tentando descobrir onde um blend de paralelo acontece em relação ao oversampling vai apreciar a clareza.

    Ganho de entrada: aqui o botão não é volume, é timbre

    Essa é a parte que mais gera confusão em quem vem de plugins convencionais, e o manual não poupa palavras: em equipamento capturado, o nível de entrada é o instrumento.

    Como o modelo é não-linear, o quanto de sinal você manda para dentro dele determina quão forte o equipamento capturado está sendo empurrado — e portanto quanta saturação e quanta compressão você vai ouvir. Não é um ajuste de volume com o timbre definido em outro lugar. É o controle de caráter.

    Vale registrar que isso não é exclusividade do NAM. Qualquer processo não-linear se comporta assim, inclusive uma modelagem física de um pré valvulado. O que muda entre os dois métodos é o alcance: a captura tem teto, a modelagem física extrapola.

    Input L / Input R

    Trim por canal, com um ícone de corrente que trava os dois para se moverem juntos — a escolha normal em material estéreo. Destrave para equilibrar canais desalinhados.

    Drive

    O macro vermelho, um empurrão global para dentro do modelo por cima dos trims de entrada. Para cima bate mais forte no equipamento, para baixo mantém limpo. A faixa padrão é de ±24 dB.

    Há uma pequena aba vermelha no canto superior esquerdo do Drive, o 2× Drive, que dobra essa faixa para ±48 dB. Serve para capturas que pedem ser empurradas muito além do normal, ou recuadas muito abaixo. A maioria das fontes nunca precisa disso.

    O teto da captura

    Repetindo porque é o ponto mais importante do plugin inteiro: a captura só entrega a saturação que foi gravada nela. Se você quer mais sujeira e o knob acabou, a solução não é forçar — é procurar uma captura mais colorida. O próprio guia rápido do manual diz isso com todas as letras.

    Auto Input, Auto Gain, Bypass e Delta: a rotina de comparação honesta

    Quatro controles que, usados em sequência, resolvem o problema mais antigo de julgar saturação: distinguir “melhor” de “mais alto”.

    Auto Input mede o RMS de banda larga do sinal que chega e ajusta o trim de entrada para que ele fique no nível de referência em que os modelos NAM são caracterizados: −21,1 dBFS RMS. Enquanto mede, os trims mostram uma prévia ao vivo; o resultado se fixa quando a janela de análise termina, e uma segunda pressão trava a medição antes disso. Um pequeno knob ao lado define a janela, de 3 a 30 segundos — janelas mais longas dão leituras mais estáveis em fontes dinâmicas. Trate como ponto de partida, não como verdade fixa.

    Auto Gain compara a loudness ponderada em K (ITU-R BS.1770, escala LUFS) da entrada contra a saída processada e ajusta o Output para que as duas coincidam em loudness percebida. É isso que torna o A/B honesto: você aciona o Bypass e compara timbre, não volume.

    Bypass é bypass verdadeiro, passando o sinal seco intocado. O plugin reporta sua latência ao host, então o bypass permanece alinhado no tempo, e o próprio chaveamento é um crossfade curto de cerca de 5 ms — sem cliques mesmo em material alto. E ele tem sempre a última palavra: acionar o Bypass com o Delta ativo entrega o sinal seco limpo.

    Delta emite apenas a diferença entre o processado e o seco. Exatamente o que o plugin está somando ou retirando: harmônicos, deslocamento de equalização, artefatos de compressão. É o jeito mais rápido de ouvir o que a sua coloração realmente faz.

    HQ: rede completa ou enxuta

    Ligado, em vermelho, a captura roda no tamanho de rede completo, com a melhor qualidade possível. Desligado, o modelo roda em versão reduzida, trocando um pouco de fidelidade por menos CPU — útil quando você está gravando com muitas instâncias abertas.

    Ao alternar, você vai ouvir uma queda breve e deliberada de cerca de 8 ms. É o handover sem clique enquanto o motor troca o tamanho da rede, não um defeito. O HQ é a face visível do parâmetro automatizável Slim, que o motor trata como chave de dois estados, então a automação vira limpa no ponto médio.

    NAM Sets e o knob de Morph

    Aqui está a resposta da captura ao seu ponto fraco estrutural.

    Um NAM Set é um preset que contém uma série de capturas relacionadas em vez de uma só, com um knob de Morph para varrer entre elas. Pense num pedal de drive capturado em cinco ajustes de entrada, ou num compressor capturado em várias razões. O set agrupa esses instantâneos num único slot para que você atravesse a faixa com um controle contínuo, em vez de trocar de preset.

    A diferença entre Drive e Morph

    Vale fixar, porque os dois parecem fazer a mesma coisa e não fazem:

    • Drive manda mais sinal para dentro do mesmo modelo. Você explora a não-linearidade daquela captura específica.
    • Morph troca de modelo dentro da série. Você não está empurrando mais sinal, está mudando qual snapshot do hardware está tocando.

    Na analogia do hardware real: o Drive é você aumentar o volume do que manda para a máquina; o Morph é você ir até a máquina e girar o botão de ganho dela.

    Os dois não competem — o Drive continua ativo sobre o modelo que o Morph selecionou. Dá para escolher o estágio e depois ajustar quanto você empurra dentro dele.

    Realismo: ganha, mas com ressalva

    Num hardware real, girar o ganho não só aumenta o nível: muda a curva de distorção, o ponto de polarização, a resposta de frequência, o comportamento dinâmico. Um único NAM captura um desses estados. O set captura vários estados reais e interpola entre eles.

    Logo, os pontos onde o Morph pousa exatamente sobre um membro são fiéis por definição. As regiões intermediárias são mistura, não medição. A qualidade dessas zonas depende de quão próximos entre si os membros foram capturados: um set com passos largos terá transições mais sintéticas que um com passos finos.

    Carregando, salvando e automatizando

    Sets de fábrica ficam no menu Factory NAM Sets, separados dos presets comuns. O item Load NAM Set… constrói um set na hora a partir de uma pasta de capturas — aponte para a pasta cujos arquivos .nam são os membros desejados. Quando um set está carregado e você usa Save As, ele é guardado como arquivo .no3set e aparece em User NAM Sets.

    O Morph é automatizável. Por ser um parâmetro contínuo, dá para programar uma passagem do limpo ao saturado ao longo de uma seção direto na DAW.

    Atenção a um detalhe que gera chamados de suporte: abaixo do knob de Morph existe um pequeno botão redondo de descarregamento. Vermelho significa que o set inteiro está residente na memória e o Morph está vivo. Cinza colapsa o set para apenas o modelo da posição atual, liberando CPU e memória — e congelando a varredura. Se a automação está se movendo, mantenha vermelho.

    Slots de captura e troca de modelo

    São dois slots independentes. Clique para navegar e carregar um .nam; o pequeno botão quadrado ao lado limpa o slot. Cada slot carregado exibe um chip de arquitetura — o tipo de rede do modelo, como A2, A1 ou LSTM — e, quando a captura carrega metadados de loudness, o nível de saída dela. Esse segundo dado é mais útil do que parece: é uma leitura confiável de quão quente a captura corre, o que ajuda a julgar o ganho de compensação.

    Os rótulos dos slots seguem o modo de processamento. O Slot A lê Mono / Left / Mid e o Slot B lê Right / Side. Em Stereo, A processa a esquerda e B a direita; em Mid-Side, A processa o centro e B as laterais — o que permite rodar equipamentos diferentes no centro e no conteúdo estéreo.

    Abaixo do campo do Slot B há um seletor de quatro vias: AA / AB / BA / BB. Ele decide qual modelo carregado alimenta qual canal de processamento sem recarregar nada. AB é o mapeamento natural e o padrão. BA inverte. AA roda o modelo A nos dois canais, BB roda o B. É o jeito rápido de comparar duas capturas no mesmo material.

    Mid/Side em dois pontos da cadeia

    O M-S Pre aplica um balanço mid/side antes do modelo: inclina o drive entre o componente central e o de diferença estéreo. Dá para empurrar as laterais mais forte que o centro, por exemplo.

    O M-S Post faz o mesmo depois do modelo, reequilibrando centro e laterais no sinal já processado. O ícone de corrente entre os dois knobs os liga como imagens espelhadas: mova um e o outro acompanha inversamente, para inclinações simétricas rápidas.

    O modo Mid-Side propriamente dito codifica para centro e laterais, processa cada um independentemente com modelos diferentes, e decodifica de volta. Saturar o centro de um jeito e a ambiência estéreo de outro é algo que exige um rack inteiro no mundo analógico.

    A fileira de roteamento também traz solos de Left, Right, Mid e Side. São auxílios de monitoração — não alteram a saída impressa. Solar Side para ouvir só o que está acontecendo com o conteúdo estéreo é um hábito que revela problemas cedo.

    Oversampling: dois motores independentes

    Saturação cria harmônicos acima da banda de áudio. Sem oversampling eles dobram para dentro como aliasing — artefatos ásperos e inarmônicos. O oversampling roda o estágio não-linear numa taxa interna mais alta para que esses harmônicos sejam filtrados antes da redução de taxa.

    O plugin traz duas configurações separadas. Real Time vale durante reprodução e gravação, onde você equilibra qualidade contra CPU. Offline vale durante o bounce, permitindo imprimir com um fator mais caro sem travar a reprodução ao vivo. Um ícone de corrente entre os dois painéis espelha as configurações — ligado por padrão, para que o que você imprime corresponda ao que ouviu. Desligue quando quiser uma configuração mais pesada só na renderização final.

    Fator: Off, 2×, 4×, 8×, 16×, 32×

    Quanto maior, menos aliasing e mais CPU. De 2× a 4× é suficiente para cor suave; 8× para cima quando o drive é pesado.

    O que “Off” realmente significa

    Esse ponto costuma escapar. Em Off, o modelo roda na taxa nativa dele — para praticamente toda captura NAM, 48 kHz. Se a sua sessão roda na mesma taxa, o sinal passa direto, sem conversão e sem filtro no caminho.

    Mas se a sua sessão roda em outra taxa — 44,1, 88,2, 96 kHz — o plugin converte a taxa em torno do modelo, e o filtro anti-aliasing que você selecionou governa essa conversão. Ou seja: a escolha de filtro é audível mesmo com o oversampling desligado. Quem trabalha a 44,1 precisa saber disso.

    Filtros: IIR, Min FIR, Poly, Linear

    IIR (fase mínima) e Min FIR são de baixa latência e pré-ringing mínimo — boa escolha para gravação. Poly (FIR polifásico) e Linear (fase linear) são coerentes em fase e mais íngremes, ao custo de latência e possível pré-ringing — melhores para mixagem e masterização.

    DC Block

    Um passa-altas de limpeza que remove o deslocamento DC e o acúmulo subsônico que a saturação introduz. A tira abaixo da seção de oversampling tem dois seletores — esquerdo para o motor Real Time, direito para o Offline — compartilhando um único knob de corte.

    • Off desativa o filtro naquele motor.
    • Min, de fase mínima, é um passa-altas suave e de baixa latência que preserva o timing dos transientes. A escolha do dia a dia.
    • Linear, de fase linear, é coerente sem borrar os graves, ao custo de latência e possível pré-ringing. Melhor para masterização e trabalho mid-side.

    O knob define a frequência de corte entre 2 e 200 Hz, e dá para clicar no valor e digitar. Mantenha baixo para tirar só DC e subsônicos; suba para limpar graves indesejados de fato. A barra de status de cada painel de oversampling mostra o corte ativo e a latência somada por aquele motor.

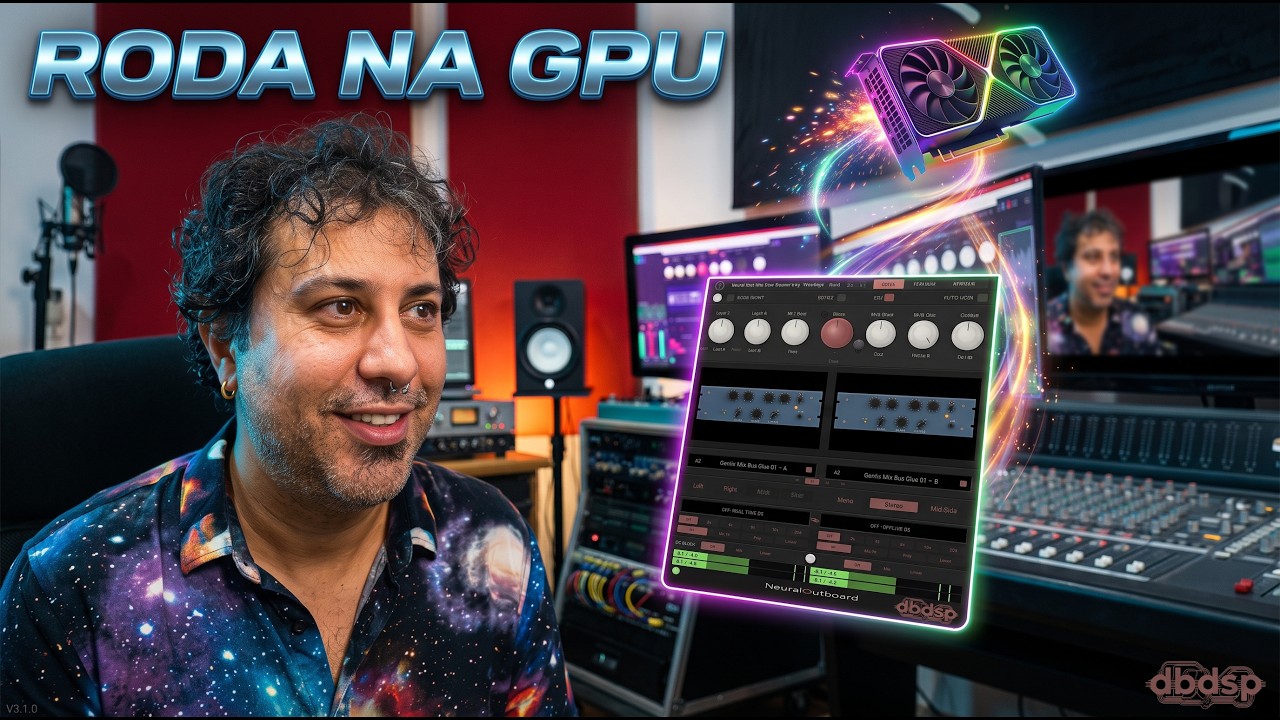
    Aceleração por GPU: a novidade que muda a conta

    Inferência de rede neural amostra a amostra, ainda por cima oversamplada, é cara. O próprio manual admite que em fatores altos uma única instância consegue saturar um núcleo de CPU. A versão 3.2 ataca isso entregando o modelo à placa de vídeo.

    São dois botões no cabeçalho, mutuamente exclusivos — clicar em um desliga o outro, clicar no que está aceso volta para a CPU, e a mudança tem efeito imediato:

    GPU

    O modelo roda na placa e o plugin reporta um buffer extra de latência ao host. A compensação de delay cuida disso, então nada sai do tempo; você simplesmente tem um buffer a mais de round-trip. É o modo de mixagem e masterização, onde um buffer não custa nada e a folga liberada permite empilhar instâncias ou rodar oversampling pesado que de outro modo seria inviável.

    GPU +0ms

    O mesmo processamento sem nenhuma latência somada. O plugin espera a placa dentro do mesmo bloco de processamento em vez de devolver o anterior. Isso custa capacidade — consideravelmente menos instâncias que o modo GPU — mas não acrescenta nada ao caminho de monitoração. É o modo de gravação e monitoração ao vivo, e ainda assim roda confortavelmente mais instâncias do que a CPU consegue na mesma latência zero.

    É o mesmo som?

    Sim. O caminho da GPU é verificado contra o da CPU até o limite do ponto flutuante de 32 bits — uma diferença muito abaixo de qualquer coisa audível, e muito abaixo da diferença entre duas tomadas da mesma performance. O que muda não é o timbre, é quanto você consegue rodar.

    A configuração segue a máquina, não o preset

    Decisão de projeto elegante e que merece destaque: se um modelo roda na GPU é propriedade do computador em que você trabalha, não do som. Trocar de preset, carregar um pack de fábrica ou abrir um NAM Set nunca altera isso, e um preset que você compartilha jamais força modo GPU na máquina de outra pessoa. O plugin lembra sua última escolha e abre novas instâncias assim, enquanto um projeto salvo restaura o que aquele projeto estava usando.

    Quando não ajuda, e o que acontece se falhar

    Notebooks com gráficos integrados ao processador dividem banda de memória com a CPU, então o ganho pode ser pequeno. Se um modelo não puder ser movido para a placa, o plugin explica o motivo e continua na CPU.

    E se a placa parar de responder — reset de driver, dispositivo removido, qualquer falha — o plugin devolve todas as instâncias para a CPU, avisa que fez isso, e segue tocando. Você perde o offload, não o áudio.

    Requisitos: no Windows, placa com suporte a Direct3D 12; no macOS, Metal, que todo Mac suportado oferece.

    Presets, capturas próprias e packs de expansão

    O menu de presets

    Clicando no campo de preset você encontra, de cima para baixo: Default, Factory Packs (um submenu por pack instalado, organizado por categoria), Factory NAM Sets (packs cujos presets são sets, mantidos separados), User Presets, User NAM Sets, além de Delete current, Reveal folder, Load NAM Set…, User Manual, um item de atualização que só aparece quando há versão nova, e License…

    Seus presets ficam em ~/Library/Application Support/NeuralOutboard/Presets/ no macOS e em %LOCALAPPDATA%\NeuralOutboard\Presets\ no Windows.

    Um aviso que evita dor de cabeça: um preset referencia suas capturas por caminho de arquivo. Se você mover ou apagar um .nam, os presets que o usam não conseguem carregá-lo. Mantenha sua biblioteca de capturas num local estável.

    Foto do hardware nas suas próprias capturas

    O painel entre os knobs e os slots mostra a foto do equipamento por trás de cada captura carregada, Slot A à esquerda e Slot B à direita. Uma seta no canto esquerdo da fileira de knobs recolhe ou revela a vista, e a janela redimensiona junto.

    Packs de expansão trazem as imagens embutidas. Para o seu próprio conteúdo a regra é uma só: mesma pasta, mesmo nome. Coloque uma imagem ao lado da captura com nome idêntico e extensão .png, .jpg ou .jpeg. MeuPre.nam + MeuPre.png e a foto aparece sempre que a captura for carregada, inclusive quando o preset for recuperado numa sessão salva.

    Packs de expansão

    Packs são coleções de capturas com fotos e categorias embutidas, instaladas por instalador próprio: um .pkg dentro de imagem de disco no macOS, um .exe no Windows. Aparecem no menu automaticamente, sem precisar reiniciar nada além da janela do plugin.

    Packs pagos mostram um cadeado. Selecionar um preset deles abre o painel de desbloqueio: cole a chave do recibo e pressione Unlock — o preset que você clicou carrega no instante em que a chave valida. Um pack desbloqueado permanece desbloqueado, inclusive através de reinstalações. Packs podem oferecer chaves de teste com prazo; inserir uma chave comprada a qualquer momento, mesmo por cima de um teste vencido, desbloqueia permanentemente.

    Licenciamento, atualizações e privacidade

    O teste gratuito dura 14 dias e é o plugin completo, sem restrições, em um computador. Basta abrir o painel de licença pelo menu de presets e apertar um botão, sem chave. Uma licença comprada cobre até três computadores simultâneos; para migrar, desative um pelo portal do cliente e ative no novo. Existe ainda um “Reset this machine” local, que limpa o estado de ativação daquele computador sem consumir nem liberar assentos.

    Ativação e reverificação periódica pedem internet, mas uma vez ativado o plugin tolera ficar offline por um período de carência razoável.

    Sobre atualizações: no máximo uma vez por dia o plugin busca um pequeno arquivo de versão no site. Havendo versão nova, aparece uma aba amarela sobre o wordmark na parte de baixo e uma entrada no menu de presets. Nada se atualiza sozinho. Instalar uma atualização é rodar o instalador por cima; ativação, desbloqueios de pack, presets de usuário e packs instalados não são tocados.

    A verificação de atualização é uma requisição web comum. Como qualquer requisição, revela seu endereço IP e um identificador genérico de software ao servidor — e nada além disso: nenhuma conta, uso, áudio ou dado pessoal. Offline, a checagem falha silenciosamente.

    Especificações resumidas

    Formatos macOS: AU, VST3 e AAX — Windows: VST3 e AAX
    Plataforma macOS em binário universal (Apple Silicon e Intel); Windows 10 ou superior, 64 bits
    Motor Núcleo de inferência do Neural Amp Modeler com processamento não-linear oversamplado; tamanho de rede completo ou enxuto
    Capturas .nam — arquitetura A2 e modelos A1 legados; foto opcional .png / .jpg / .jpeg de mesmo nome
    NAM Sets Presets multi-captura com Morph contínuo e descarregamento; sets de usuário em .no3set
    Nível de referência −21,1 dBFS RMS
    Modos Mono, Stereo, Mid-Side, com troca de modelo AA/AB/BA/BB
    Faixa de Drive ±24 dB, ou ±48 dB com 2× Drive
    Oversampling Motores Real-Time e Offline independentes ou vinculados, de Off a 32×, filtros IIR / Min FIR / Poly / Linear
    DC Block Modos independentes por motor: Off / Min / Linear, corte compartilhado de 2 a 200 Hz
    GPU Opcional por instância; modo padrão com um buffer de latência, modo zero-latência; fallback automático para CPU. Windows: Direct3D 12. macOS: Metal
    Licença Teste completo de 14 dias em um computador; licença comprada cobre até 3 máquinas

    Onde encontrar capturas para mixagem

    Aqui está o gargalo real da categoria, e vale ser franco a respeito.

    O NeuralOutboard acompanha dez pacotes gratuitos de captura de hardware real, que chegam como instaladores próprios e aparecem sozinhos no menu. Entre eles estão os chamados MAX banks: capturas feitas com válvula, transformador ou fita empurrados até o teto, de modo que recuar o Drive te leva por todos os estágios de saturação, do totalmente saturado ao limpo. É a melhor fonte imediata, porque foi feita pensando em mixagem desde o início.

    Fora isso, o TONE3000 é a maior biblioteca pública e cobre explicitamente outboard e cadeias de sinal completas, além de amplificadores. O problema é curadoria: o material de mixagem está diluído em meio a um volume enorme de capturas de guitarra.

    Existe uma preocupação comum aqui que vale desfazer: a de que capturas do TONE3000 “foram treinadas com som de guitarra” e por isso não serviriam para bateria ou voz. Não é como o processo funciona. A captura é feita passando um sinal de teste padronizado pelo equipamento e gravando a saída; a rede aprende a relação entrada→saída do circuito, não o timbre de um instrumento.

    O que de fato importa é a cobertura — se o sinal de treino excitou o equipamento em toda a faixa de nível e frequência que você vai usar. E aí existem limitações reais, só que outras: a grande maioria das capturas é mono, cada arquivo é o retrato de um único ajuste, e capturas feitas pensando em guitarra podem ter pouca energia grave no sinal de treino, o que torna o comportamento em 40 Hz uma extrapolação. Vale testar com um bumbo antes de confiar numa captura desconhecida no barramento.

    Limitações, ditas sem rodeio

    Nenhuma ferramenta merece um texto que só elogia. Os pontos que você deve pesar:

    • O teto da captura é real e intransponível. Nenhum knob produz saturação que não foi gravada. Os NAM Sets amenizam, mas são uma solução de contorno — interatividade de parâmetro continua sendo a fraqueza estrutural da abordagem de caixa-preta.
    • Continua sendo pesado. A GPU muda a conta, mas não a elimina, e em máquinas com gráficos integrados pode não mudar quase nada.
    • Capturas de qualidade para mixagem ainda são escassas comparadas ao universo de captura de amplificador.
    • Dependência de caminho de arquivo nos presets exige disciplina de organização da biblioteca.

    Vale ainda dizer que modelagem física a nível de componente não está obsoleta e provavelmente ainda vai render muito. As duas abordagens resolvem problemas diferentes: a física dá interatividade total e extrapolação; a captura dá acesso a equipamento que ninguém se deu ao trabalho de modelar. Não é preciso escolher lado.

    🎯 Quer levar sua Mixagem ao nível profissional?

    Auto Gain, Bypass e Delta resolvem a comparação honesta — mas nenhum botão decide por você o que soa melhor. Isso é audição crítica, e se aprende. Domine o processo completo de mixagem e o tratamento dinâmico, do básico ao extremo avançado.

    CONHECER O CURSO FM3.5

    Conclusão

    O NeuralOutboard é uma ferramenta madura e pensada por quem mistura de verdade. Os detalhes entregam isso: o Auto Gain com ponderação K, o bypass com crossfade e alinhamento de latência, os motores de oversampling separados para reprodução e bounce, a decisão de amarrar a escolha de GPU à máquina em vez do preset. São escolhas de quem já se irritou com plugins que não fazem nada disso.

    A aceleração por GPU é a novidade que justifica o upgrade, não por soar melhor — ela é verificadamente idêntica — mas por tornar praticável um fluxo de trabalho que antes exigia render a cada decisão. E os NAM Sets apontam para onde a captura neural precisa evoluir.

    Se a sua curiosidade era saber se dá para montar uma cadeia analógica inteira dentro da DAW usando modelos de equipamento real, a resposta hoje é sim. O limite deixou de ser o processador e passou a ser a sua biblioteca de capturas.
  • TONE3000 lança plugin Gratuito com + de 700 Mil Capturas para Guitarra e Contrabaixo

    TONE3000 lança plugin Gratuito com + de 700 Mil Capturas para Guitarra e Contrabaixo

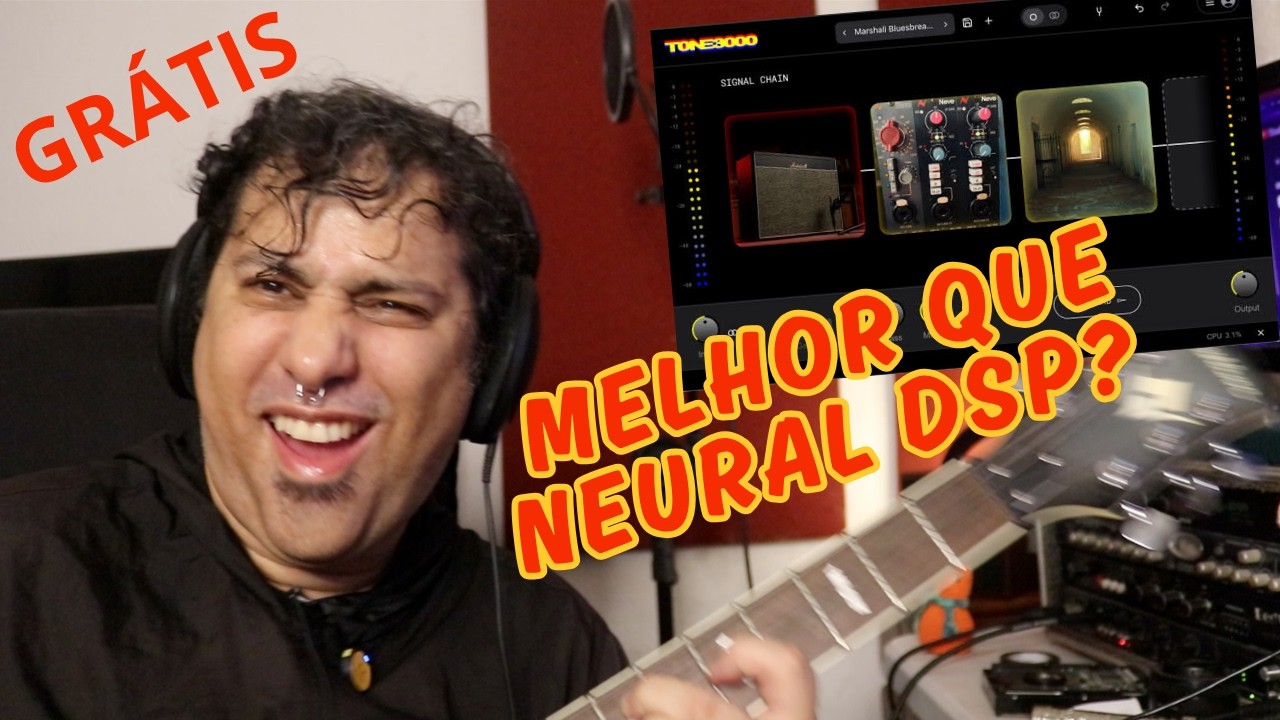
    O TONE3000 lançou um plugin gratuito e de código aberto que dá acesso a mais de 700 mil capturas neurais e IRs, rodando a nova arquitetura NAM A2. Neste artigo você entende o que mudou na tecnologia, o que mostram os números de precisão e consumo de CPU e por que isso pressiona empresas como Neural DSP, IK Multimedia e Line 6. O vídeo abaixo traz um resumo, e o texto aprofunda cada ponto.

    Resumo para quem tem pressa: em 1º de setembro de 2026 o TONE3000 lançou um plugin gratuito e de código aberto que dá acesso direto a mais de 700 mil capturas neurais e IRs. Ele roda a NAM A2, arquitetura lançada em 2 de junho de 2026, que é mais precisa que a geração anterior consumindo 30 a 40% menos CPU — e é eficiente o bastante para rodar nativamente em um chip de 3 dólares. Este artigo explica a tecnologia por dentro, os números, a metodologia dos testes e por que isso pressiona o modelo de negócio de Neural DSP, IK Multimedia e Line 6.

    O que mudou no jogo

    Simulação de amplificador sempre foi um problema de engenharia caro. Uma empresa contratava especialistas em DSP, media um amplificador real componente por componente, escrevia código que reproduzia aquele comportamento e vendia o resultado como plugin fechado. O ciclo levava anos e custava centenas de milhares de dólares por produto. O usuário recebia um conjunto fixo de timbres, e mais timbres significavam nova compra.

    A modelagem neural inverteu essa lógica. Em vez de descrever o circuito, você grava o equipamento respondendo a um sinal de teste e treina uma rede neural para prever, amostra por amostra, o que aquele equipamento faria com qualquer entrada. O modelo não sabe o que é uma válvula. Ele aprende a função de transferência não linear do conjunto inteiro — pré, power amp, transformador, alto-falante, microfone, sala — a partir do áudio.

    O Neural Amp Modeler (NAM), criado por Steve Atkinson, foi a implementação aberta dessa ideia. O TONE3000 (antigo ToneHunt) virou o repositório central dessas capturas. E a A2 é o ponto em que essa tecnologia aberta passou a ganhar dos sistemas proprietários nos próprios testes que a indústria usa para se avaliar.

    Anatomia da A2: o que exatamente mudou

    A A2 é resultado de uma parceria de seis meses entre o TONE3000 e Steve Atkinson. O time técnico foi formado por Woodbury Shortridge (cofundador e CTO do TONE3000), João Felipe Santos (engenheiro de machine learning e sistemas embarcados) e o próprio Atkinson.

    Ainda é uma WaveNet?

    Só no espírito. A A2 mantém a assinatura da WaveNet — convoluções causais dilatadas com conexões residuais e de skip — mas se afasta do artigo original de van den Oord e colegas em quase todo o resto.

    A diferença estrutural mais importante: a WaveNet clássica é autorregressiva e generativa. Ela prevê uma distribuição de probabilidade para cada amostra a partir de todas as anteriores e gera áudio sequencialmente, o que é inviável em tempo real. A A2 é feedforward e determinística: mapeia áudio de entrada para áudio de saída em uma única passada. A saída também é diferente. A WaveNet emite uma distribuição categórica de 256 valores sobre amostras quantizadas em µ-law e treina maximizando log-verossimilhança; a A2 emite a amostra diretamente e treina com perda de regressão.

    A troca que destravou tudo: tanh → leaky ReLU

    A mudança isolada mais importante foi a função de ativação. A A1 usava tangente hiperbólica. A tanh é precisa, tanto no erro amostra a amostra quanto no comportamento em frequência, mas é cara de calcular em redes muito pequenas — e redes de amp modeling são minúsculas por definição, já que precisam rodar em buffers de dezenas de amostras.

    Trocar por leaky ReLU (α = 0,01) liberou orçamento de CPU suficiente para aumentar a rede. O resultado, confirmado em muitos experimentos: uma rede maior com uma ativação mais barata é mais precisa pelo mesmo custo computacional. A ativação gated característica da WaveNet — tanh multiplicada por sigmoide — foi eliminada por completo.

    Dilatações, degridding e campo receptivo

    A WaveNet dobra as dilatações (1, 2, 4, 8… 512) e repete o padrão. A A2 usa um cronograma não dobrado, ajustado à mão e validado por otimização de hiperparâmetros: 1, 3, 7, 17, 41, 101, 239, distribuído em três pilhas de dilatação, num total de 23 camadas.

    Entre a segunda e a terceira pilha entra um par de camadas de kernel largo (k = 15) que faz o que o time chama de degridding. O problema é conhecido em convoluções dilatadas empilhadas: elas tendem ao gridding, ou seja, posições da entrada que nunca são amostradas. Essas lacunas favorecem o acúmulo de harmônicos ímpares e produzem o ringing metálico que a galera reclamava em capturas de high gain. As camadas de degridding remisturam essas lacunas e reiniciam o campo receptivo efetivo. Isso só é possível porque a A2 permite misturar tamanhos de kernel dentro de um mesmo array de camadas — a A1 e a WaveNet original davam a cada pilha um kernel único.

    O campo receptivo cresceu cerca de 50%: 6.332 amostras, aproximadamente 132 ms a 48 kHz, contra cerca de 4.100 amostras (~85 ms) na A1-Standard. Em termos práticos, o modelo enxerga uma janela maior do passado recente antes de prever a resposta. É essa memória curta que permite capturar comportamento dependente do tempo: sag de fonte, bloom de válvula entrando em breakup, e compressores com attack e release em ajustes realistas — que a A1 não modelava bem.

    Por fim, a cabeça da rede mudou. Na A1 ela operava por amostra, como um waveshaper. Na A2 ela é convolucional, atuando sobre uma janela, o que a torna um misturador mais expressivo e ajuda a suavizar artefatos parecidos com aliasing, moldando a resposta de alta frequência diretamente.

    Slimmable e packed training: um arquivo, dois tamanhos

    Aqui está a sacada de engenharia que viabiliza o resto do ecossistema. Slimmable NAM é uma técnica desenvolvida por Atkinson que permite que uma única rede treinada rode em larguras diferentes, produzindo variantes de tamanho sem retreinar. O artigo, Slimmable NAM: Neural Amp Models with adjustable runtime computational cost, foi aceito no workshop de IA para Música do NeurIPS 2025 (arxiv.org/abs/2511.07470).

    A A2 usa uma variante chamada packed training. Na abordagem slimmable original, o tamanho menor é uma sub-fatia de canais do maior, e compartilhar pesos entre os dois custa precisão. Na versão packed, cada tamanho recebe seu próprio bloco de pesos dentro do mesmo modelo: eles treinam juntos, mas as camadas são estruturadas em blocos de modo que cada tamanho só lê e escreve nos próprios canais, com uma máscara zerando os pesos cruzados a cada passo do otimizador. Nenhum dos dois precisa se comprometer pelo outro.

    Resultado: uma rede de 8 canais (A2-Full) e uma de 3 canais (A2-Lite) empacotadas em um único arquivo. Você baixa uma vez; o dispositivo escolhe o que a CPU dele aguenta.

    A receita de treino

    Foram mais de dez mil treinamentos em experimentos de HPO, variando kernels, padrões de dilatação, contagem de canais, ativações e escolhas arquiteturais. A perda final ficou em MSE mais um termo pequeno de MRSTFT (transformada de Fourier de curto tempo em múltiplas resoluções) para manter o comportamento em frequência honesto; a maioria das funções de perda novas testadas foi descartada. O ESR é usado como validação para escolher o melhor checkpoint. Os dados de treino são normalizados para uma referência fixa de -18 dB RMS — o nível para o qual a HPO foi calibrada — e o reescalonamento é dobrado de volta na escala da cabeça, o que mantém a saída nivelada sem passo extra na inferência e faz todo tom treinar sob as mesmas condições.

    Também foram exploradas e descartadas: arquiteturas base alternativas (LSTM e um modelo Hammerstein-Wiener sob medida), meia dúzia de ativações, camadas FiLM, convolução agrupada, gargalos nas camadas WaveNet, EMA de pesos, quantização agressiva e destilação. Quando os resultados empatavam, a simplicidade ganhava.

    Detalhe folclórico para quem gosta: mais de 42 arquiteturas chegaram a estágio de candidata a produção, e o time passou a batizá-las com nomes de personagens de O Senhor dos Anéis. A final foi entre Boromir e Legolas. Boromir venceu.

    Os números

    Precisão

    Quando o TONE3000 retreinou a biblioteca inteira de A1 para A2, comparou o ESR de cada modelo antes e depois. A mediana caiu praticamente pela metade: de 0,0062 na A1-Standard para 0,0033 na A2-Full (menor é melhor). Isso significa que o modelo A2 acompanha o equipamento real mais de perto, amostra por amostra.

    Eficiência

    Métrica A1-Standard A2-Full A2-Lite
    Canais 8 3
    Campo receptivo ~4.100 amostras (~85 ms) 6.332 amostras (~132 ms) 6.332 amostras (~132 ms)
    Custo de CPU referência 30–40% menor fração do orçamento
    Instâncias simultâneas (MacBook Apple Silicon) ~64 ~200
    Alvo DAW DAW e hardware com folga pedaleiras e amps embarcados

    Você roda três A2-Full pelo custo de CPU de duas A1-Standard, com precisão maior. E a A2-Lite roda a 50% de CPU em um ARM Cortex-M7 de 600 MHz — o chip que custa cerca de 3 dólares por unidade em compras de volume e que está dentro de boa parte das pedaleiras de mercado de massa. Mesmo nesse tamanho reduzido, a A2-Lite ainda superou todos os modeladores comerciais testados, e nos testes cegos ficou lado a lado com a A1-Standard.

    A parte que quase ninguém comenta: o motor de inferência

    Metade do ganho de eficiência não veio da arquitetura, e sim de engenharia de inferência. A operação quente numa WaveNet é a convolução 1×1 que mistura canais — na prática, uma multiplicação de matriz pequena, executada uma vez por camada por bloco. Bibliotecas matemáticas de uso geral são otimizadas para matrizes grandes e desperdiçam tempo em setup e alocações temporárias nos tamanhos minúsculos da NAM.

    O caminho rápido do NeuralAmpModelerCore troca isso por kernels totalmente desenrolados, residentes em registrador, dimensionados para as contagens de canais da A2. Em um Apple M5, isso levou a A2-Lite de um fator de tempo real de 50x no caminho antigo com Eigen para 316x. Cerca de 6 vezes mais rápido no mesmo modelo, só com engenharia de inferência.

    No embarcado a solução foi outra: um motor em C puro, sem dependências, publicado como referência. As otimizações são de baixo nível e cada uma só ficou porque um microbenchmark provou que compensava no Cortex-M7 — multiplicações de matriz desenroladas à mão, camadas fundidas que mantêm valores intermediários em registradores, ativações por tabela de lookup no lugar de exp, pesos fixados em memória fortemente acoplada com os ring buffers em SRAM cacheada, e buffers circulares de potência de 2 para dar tempo constante por bloco. No Daisy Seed (Cortex-M7 a 480 MHz), a A2-Lite roda em tempo real com margem.

    A metodologia do teste cego (e como interpretá-la)

    Essa é a parte que separa uma alegação de marketing de uma evidência discutível. O TONE3000 rodou um teste cego formal usando MUSHRA (Multiple Stimuli with Hidden Reference and Anchor), a metodologia padrão para avaliação de qualidade percebida de áudio, usada por emissoras como BBC e EBU.

    • Mais de 1.000 participantes e mais de 100 mil avaliações.
    • Em cada rodada, o participante ouvia primeiro a gravação do equipamento real como referência, e depois pontuava versões anonimizadas do mesmo timbre numa escala de 0 a 100.
    • Os modelos comparados: A2-Full, A2-Lite, A1-Standard, A1-Nano, Neural Capture V2 da Neural DSP, ToneX da IK Multimedia e Proxy da Line 6.
    • Conforme a metodologia, dois clipes de cada rodada eram controles de qualidade: uma referência oculta (duplicata do original, que deveria pontuar alto) e uma âncora filtrada em passa-baixa (que deveria pontuar baixo). Participantes que pontuaram a referência oculta muito baixo ou a âncora muito alto foram descartados.
    • O teste quantitativo paralelo comparou saídas contra gravações reais usando ESR, MAE, LOG_MEL e MRSTFT, em 39 timbres distintos — de cleans Fender a um Neve 1073, a um Mesa Boogie Dual Rectifier no talo, com um fuzz de oitava para estressar distorção extrema. As pontuações alimentaram um rating Elo bayesiano.
    • Os testes foram feitos em março de 2026, com as versões mais recentes dos concorrentes disponíveis então.

    A ressalva honesta: o teste é do próprio fabricante. Isso não o invalida — MUSHRA com pós-triagem por âncora é metodologia séria, e o time abriu o código do teste e os dados brutos justamente convidando à replicação e à contestação. Mas quem faz o teste escolhe o conjunto de avaliação, as versões dos concorrentes e as condições. Trate como um sinal forte, não como veredito. E lembre que o teste avalia áudio gravado: uma parte grande do que faz um amplificador parecer certo acontece sob os dedos, em tempo real, e nenhuma avaliação de material gravado captura isso.

    Por que isso pressiona os gigantes

    A vantagem estrutural não é técnica, é econômica. Compare os dois modelos:

    Modelo proprietário NAM A2 / TONE3000
    Quem produz o conteúdo a empresa, com equipe de DSP a comunidade, de graça
    Crescimento do acervo por ciclo de produto diário, sem atualização de software
    Portabilidade do timbre preso ao ecossistema da marca arquivo aberto, roda onde houver suporte
    Licença da tecnologia fechada MIT, uso comercial livre
    Custo para o usuário US$ 100+ por pacote fixo zero

    A analogia certa é IR ou MIDI. Ninguém compra um “MIDI da Yamaha” que só toca em teclado Yamaha. O NAM está tentando ocupar essa posição para timbre: um protocolo, não um produto. Quando o formato é aberto e a biblioteca é comunitária, a empresa que gastou dois anos modelando um amplificador específico está competindo com alguém que capturou o mesmo amplificador num fim de semana e publicou de graça.

    O efeito já aparece no hardware. HeadRush levou o TONE3000 para toda a linha de multiefeitos, o Darkglass Anagram conecta direto à plataforma, e Blackstar, Hotone, Mooer e NUX estão no ecossistema, com Valeton a caminho. A API do TONE3000 permite que o fabricante ofereça a biblioteca inteira dentro do próprio produto, e cada tom novo publicado fica instantaneamente disponível em todos os aparelhos conectados.

    Vale registrar a crítica técnica que o TONE3000 faz a uma prática comum do setor: várias marcas convertem modelos NAM A1 para formatos proprietários para rodar nos próprios chips. Esses modelos destilados não são NAM de verdade e não preservam a mesma precisão. A existência da A2-Lite tira a justificativa técnica dessa conversão, já que agora dá para rodar NAM nativamente em chip barato.

    O plugin: o que ele resolve na prática

    Até o lançamento, usar um timbre do TONE3000 era um ritual: achar no site, baixar o arquivo, descompactar, organizar numa pasta, apontar o carregador NAM de terceiro para o diretório. Testar outro timbre significava repetir tudo. Muita gente experimentou NAM, esbarrou nesse atrito e desistiu antes de ouvir a primeira captura.

    O plugin elimina os passos intermediários. Você navega centenas de milhares de capturas e IRs — cabeçotes, gabinetes, conjuntos amp + cab, pedais, outboard, espaços acústicos e capturas experimentais — de dentro da interface. Com login na conta, seus favoritos, recentes, criados e privados aparecem lá.

    Especificações:

    • Formatos: VST3, AU, AAX, CLAP e LV2, mais aplicativo standalone (sem DAW).
    • Sistemas: macOS (Apple Silicon e Intel), Windows e Linux.
    • Chains: monta uma cadeia de sinal completa empilhando capturas e IRs sem limite fixo — por exemplo, um EP-3 na frente de um JCM800 empurrado, mais um drive, mais o IR de sua escolha.
    • Estéreo com duas cadeias simultâneas, panorâmicas independentes.
    • Código aberto, disponível em github.com/tone-3000/tone3000-plugin.
    • Sem licença, sem compra, sem upsell de pacotes de timbre.

    Migração e compatibilidade: leia antes de reclamar

    A A2 não é retrocompatível. É uma arquitetura nova, não uma atualização drop-in. Fabricantes que já suportavam A1 precisam atualizar as integrações, e a expectativa do TONE3000 é de suporte amplo no ecossistema até o fim de 2026.

    Do lado do usuário, a transição foi feita pela plataforma. A biblioteca inteira de modelos A1 foi retreinada, com duas rotas: onde havia os dados originais de treino, os modelos A2 foram treinados do zero a partir da gravação do equipamento; onde não havia, o TONE3000 gerou dados sintéticos a partir do modelo A1 e treinou em cima. Estes últimos aparecem marcados como “Convert” e soam equivalentes ao A1, mas rodam muito mais leves. Ficaram de fora apenas modelos com zero downloads e mais de 60 dias, e modelos com dados de treino malformados.

    Modelos A1 continuam acessíveis via filtro Técnico → “A1 – Legacy” na busca. Você não precisa separar arquiteturas em packs diferentes: cada tone pack suporta A2, A1 e arquiteturas customizadas ao mesmo tempo, e o aplicativo carrega o que souber ler. Capturas feitas pelo método dry/wet continuam funcionando igual.

    Para quem constrói: como adicionar suporte A2

    • Software: atualize para o NeuralAmpModelerCore v0.5.2 ou superior. É o motor de inferência em C++, e a v0.5.2 é a release que adiciona A2. O caminho rápido vem ligado por padrão pela opção de CMake NAM_ENABLE_A2_FAST, que roteia modelos com formato A2 para inferência otimizada à mão.
    • Embarcado: um motor em C++ apoiado em biblioteca matemática genérica é péssimo encaixe para um microcontrolador com FPU escalar e algumas centenas de KB de RAM. Use a referência em C puro, sem dependências, publicada em github.com/tone-3000/nam-pedal, que demonstra A2 rodando no Daisy Seed.
    • Formato binário: no embarcado, use .namb — representação binária compacta de um modelo NAM, com app companheiro para conversão sem perda de qualidade e transferência por USB ou Bluetooth.
    • Treinador: github.com/sdatkinson/neural-amp-modeler. Tudo sob licença MIT, livre para uso, modificação e envio em produtos comerciais, sem taxa.
    • API: a API do TONE3000 permite navegar e carregar a biblioteca dentro do seu produto. Hoje é preciso pedir A2 explicitamente nas chamadas; A1 segue como padrão por retrocompatibilidade, mas isso vai mudar.

    Onde a tecnologia ainda tem limites

    Um artigo que só elogia não serve para nada. Os limites reais:

    • Captura é um instantâneo. Cada arquivo representa um ponto específico dos controles do equipamento. Não existem knobs paramétricos de verdade: mudar o ganho significa outra captura. Modeladores proprietários com modelagem de componentes oferecem controles contínuos.
    • A qualidade depende de quem capturou. Uma biblioteca comunitária de 700 mil itens tem variação enorme de qualidade. Ruído na sala, nível de entrada errado, reamp mal calibrado — tudo isso vira parte do modelo. Curadoria é problema seu.
    • Fragmentação de suporte. Como A2 quebra compatibilidade, por um tempo vamos conviver com aparelhos que leem só A1, aparelhos que convertem para formato próprio e aparelhos com A2 nativo.
    • Métricas não são a mão. ESR baixo e boa pontuação MUSHRA descrevem correspondência de áudio gravado. Resposta ao toque, dinâmica sob o pick e o modo como o amplificador reage ao volume da guitarra são coisas que essas avaliações não medem diretamente. O próprio time do TONE3000 diz isso.

    🤖 Produção Musical e o Futuro: Inteligência Artificial

    Tudo que você acabou de ler é rede neural aplicada a áudio: uma máquina aprendendo o comportamento de um amplificador a partir de gravações. E isso é só uma frente. A Inteligência Artificial já está mudando como criamos, mixamos e masterizamos. Saia na frente e domine essas ferramentas hoje mesmo.

    VER O STUDIO I.A.

    Conclusão

    O que aconteceu em 2026 não foi apenas uma arquitetura melhor. Foi a combinação de três coisas que raramente andam juntas: precisão que ganha dos sistemas fechados em teste cego formal, eficiência que coloca a tecnologia num chip de 3 dólares, e licença MIT que permite qualquer fabricante embarcar isso sem pagar nada. Some a isso uma biblioteca comunitária que dobrou de tamanho em três meses e um plugin gratuito que remove o último atrito de uso, e você tem uma pressão que nenhum ciclo de produto proprietário consegue acompanhar.

    Se você produz em casa, a recomendação prática é simples: instale o plugin, carregue meia dúzia de capturas do equipamento que você conhece de ouvido, e julgue com a sua mão. É o único teste que importa de verdade.

    Perguntas frequentes

    Preciso pagar alguma coisa?

    Não. O plugin, o motor A2 e o acesso à biblioteca são gratuitos, e o código é aberto. Não existe licença para carregar e tocar timbres.

    Qual a diferença entre NAM e A2?

    NAM é o framework aberto de modelagem neural, com as ferramentas para treinar um modelo a partir de uma gravação e rodá-lo em tempo real; ele suporta várias arquiteturas, de modelos lineares a LSTMs e WaveNets. A2 é uma arquitetura específica criada dentro do NAM, pensada para ser um padrão aberto adotado pela indústria.

    Preciso escolher entre A2-Full e A2-Lite?

    Normalmente não. É um único arquivo com os dois tamanhos, e o aplicativo ou aparelho escolhe conforme o orçamento de CPU. Alguns permitem escolher manualmente.

    Preciso retreinar minhas capturas antigas?

    Não. A biblioteca foi retreinada pela plataforma, com as exceções já citadas.

    Vale mais que um Quad Cortex ou um ToneX?

    Depende do que você compra. Hardware dedicado vende integração, latência controlada, robustez de palco e suporte. O que a A2 muda é que a qualidade da captura deixou de ser o diferencial que justifica o ecossistema fechado.

    Links úteis: plugin · guia técnico completo da A2 · repositórios no GitHub

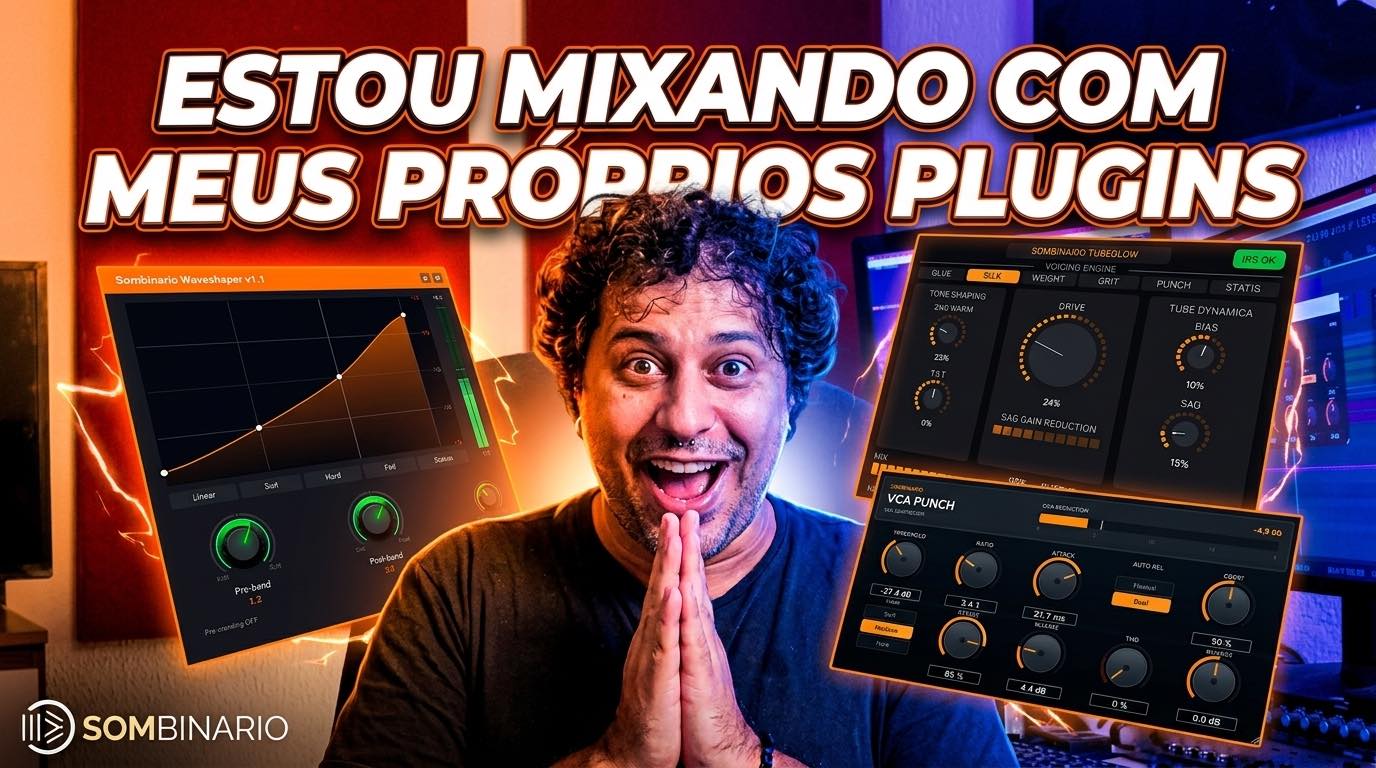
  • Estou Mixando com Meus Próprios Plugins: O Futuro da SomBinário

    Estou Mixando com Meus Próprios Plugins: O Futuro da SomBinário

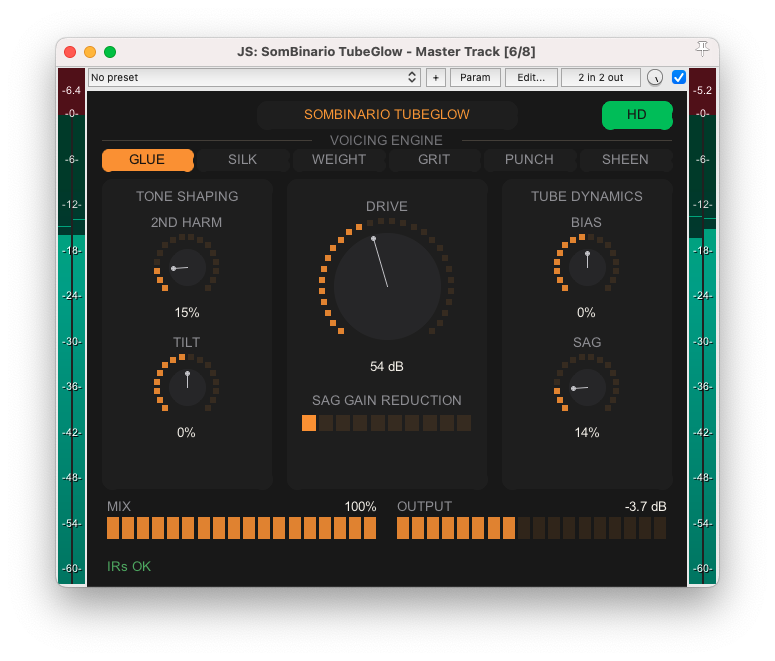
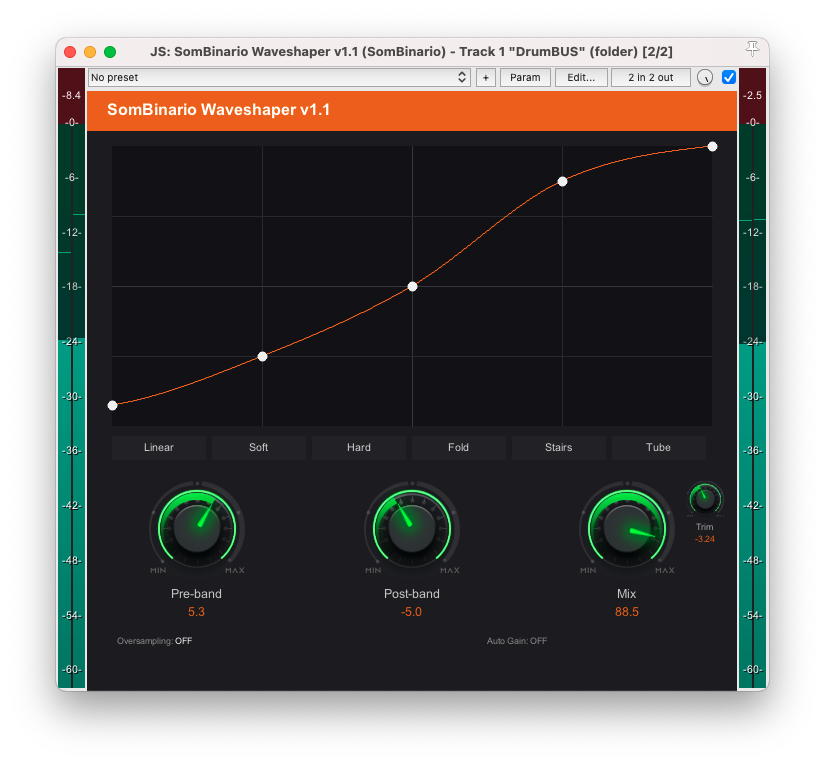
    Neste post eu apresento os plugins de áudio que desenvolvi e que agora uso em todas as minhas mixagens: o TubeGlow, de saturação valvulada, o VCA Punch, de dinâmica, e o Waveshaper, de distorção desenhada à mão. Também conto o que vem por aí com o emulador de fita TapeX e onde baixar os plugins. No vídeo abaixo você ouve cada um deles em ação.

    Fala galera! Acabei de liberar um vídeo muito especial no canal onde mostro algo que tem consumido (no bom sentido) todas as minhas energias recentemente: estou mixando exclusivamente com os plugins que eu mesmo desenvolvi!

    Nos últimos tempos, entrei em um verdadeiro hiperfoco na criação e desenvolvimento de plugins de áudio. O que começou como uma jornada programando em JSFX para o REAPER, agora escalou. Estou expandindo essas ferramentas para os formatos VST3, AU e AAX, utilizando técnicas próprias de modelagem e capturas de equipamentos reais.

    No vídeo, eu mostro exatamente o resultado sonoro dessas belezinhas em ação. Mas para quem quer conhecer um pouco mais da parte técnica, separei aqui os detalhes dos três principais processadores que estão moldando minhas novas mixagens, além de um spoiler do que vem por aí.

    1. SomBinário TubeGlow: Saturação Valvulada Autêntica

    O TubeGlow é um saturador de válvula construído a partir de capturas reais de um pré-amplificador clássico, somadas a um motor de saturação feito do zero. A grande sacada dele é o Voicing Engine, que oferece 6 perfis sonoros distintos (como GLUE para master e SILK para vocais) que combinam curvas de saturação e filtros matemáticos focados na musicalidade. Além disso, ele possui o controle SAG, que simula o comportamento de uma fonte de alimentação analógica cedendo e se recuperando sob transientes fortes, criando aquela “cola” e respiração clássica do hardware.

    2. SomBinário VCA Punch: O Motor de Dinâmica Híbrido

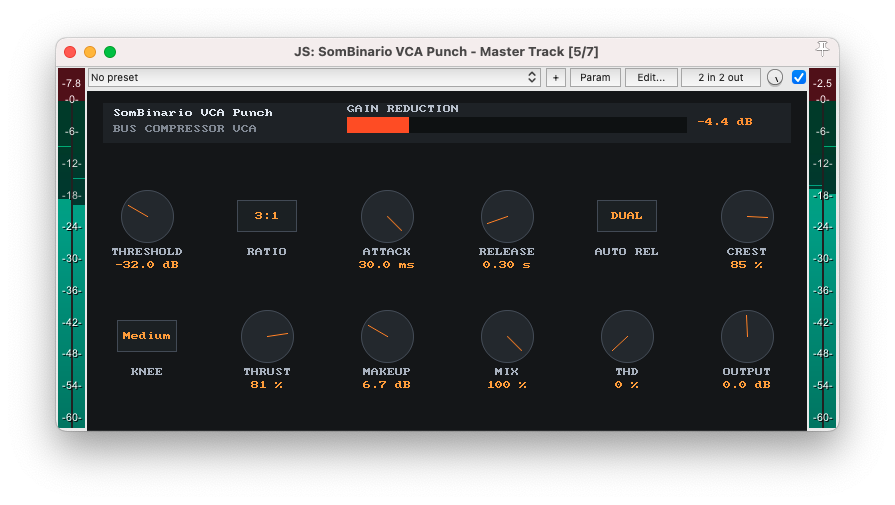
    Abaixo a versão JSFX do REAPER

    Versão JSFX - REAPER

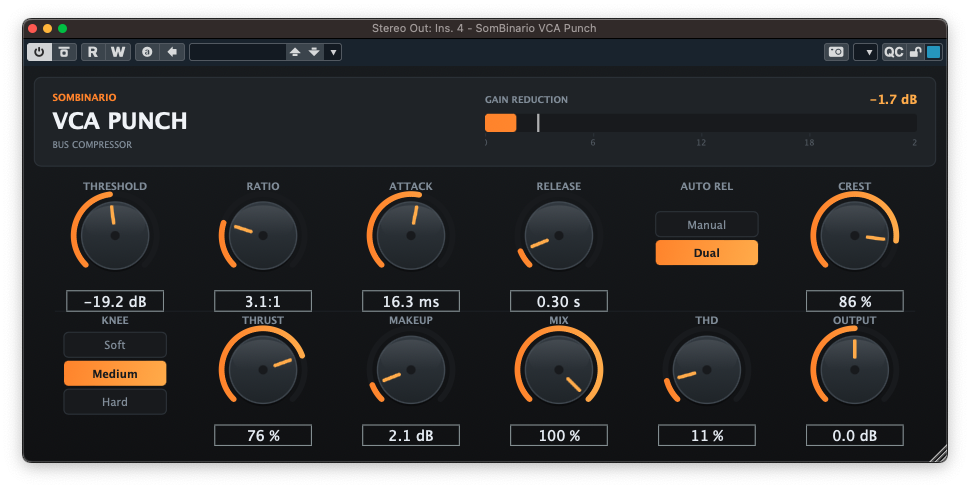
    Abaixo a versão VST3, AU e AAX:

    Se o objetivo é trazer atitude sem destruir os transientes, o VCA Punch é a resposta. Ele foi desenhado para unir a pegada rítmica dos consoles VCA com o poder da inteligência DSP[cite: 2]. O grande destaque fica por conta do motor de detecção híbrido (Crest Factor), que permite transitar entre a leitura de picos rápidos e médias RMS mais lentas, além do controle Auto Release no modo DUAL, que usa um duplo estágio inteligente para soltar transientes isolados rapidamente enquanto sustenta a redução de ganho no corpo da música, evitando o temido “pumping”. Para completar, o sidechain conta com um filtro Thrust para blindar os graves e manter o peso do bumbo e baixo intactos.

    3. SomBinário Waveshaper: Distorção Desenhada à Mão

    Para momentos em que a mix exige agressividade ou colorações não convencionais, o Waveshaper resolve o problema. Ele é um plugin de distorção de curva livre (X-Y) onde você pode simplesmente desenhar a função de transferência desejada ou usar pontos de partida pré-definidos como Soft, Hard, Fold e Tube. Para garantir a qualidade extrema em bus finais e masterização, implementei nele opções de oversampling de até 8x para eliminar problemas de aliasing, junto a um Auto Gain que compensa automaticamente o volume percebido.

    O Que Vem Por Aí: O Emulador TapeX

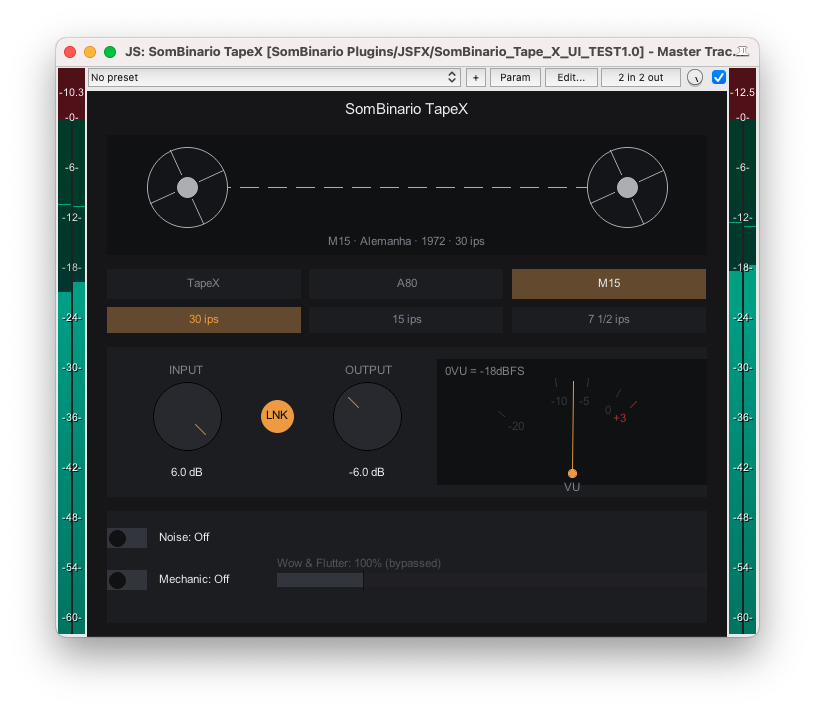
    O desenvolvimento não para por aqui. No momento, estou trabalhando pesado no TapeX, um emulador de fita magnética que promete mudar o jogo. Ele trará para a nossa realidade digital a modelagem minuciosa de duas lendas dos estúdios analógicos: a alemã Telefunken M15 e a icônica Studer A80. O foco é resgatar aquela saturação harmônica orgânica e o “glue” de fita que as maiores produções do mundo usam até hoje.

    Como Você Pode Ajudar Este Projeto

    Criar áudio DSP do zero, desenvolver interfaces, testar comportamentos e portar tudo isso para os formatos modernos exige uma carga massiva de tempo, estudos e recursos. Se você assistiu ao vídeo, curtiu a sonoridade e quer ver a SomBinário continuar expandindo essa linha de plugins, eu peço a sua ajuda.

    O apoio e as doações da comunidade são o que me permitem manter esse hiperfoco vivo. Qualquer contribuição faz uma diferença gigantesca para que eu consiga investir mais tempo desenvolvendo as ferramentas que nós, produtores, queremos usar. Assista ao vídeo lá no canal e veja os links de apoio na descrição!

    Você pode baixar os plugins nesse link: https://plugins.sombinario.com/


    🎯 Quer levar sua Mixagem ao nível profissional?

    Plugins como o TubeGlow e o VCA Punch são incríveis, mas são apenas ferramentas. Aprenda a dominar o processo completo de mixagem, a audição crítica e o tratamento dinâmico do básico ao extremo avançado e saiba tirar leite de pedra com qualquer equipamento.

    CONHECER O CURSO FM3.5

  • A I.A. é Ferramenta, Não Artista: Entenda o Impacto do Novo Selo do Spotify

    A I.A. é Ferramenta, Não Artista: Entenda o Impacto do Novo Selo do Spotify

    O Fim dos Artistas Fantasmas? Spotify Anuncia o Selo “AI Persona” (E o que isso muda para nós)

    A inteligência artificial já é uma realidade inegável dentro das nossas DAWs. Seja separando stems, gerando ideias de arranjo ou agilizando processos complexos, ela veio para ficar. No entanto, o mercado do streaming acaba de traçar uma linha clara na areia. No início de agosto, o Spotify anunciou oficialmente a criação do selo “AI Persona”, com lançamento previsto para meados de setembro de 2026.

    O objetivo? Separar criadores de conteúdo reais de identidades musicais 100% fabricadas por inteligência artificial. E, mais importante do que apenas “marcar” essas músicas, a mudança afeta diretamente como elas são distribuídas pelo algoritmo da plataforma.

    Como a nova regra funciona na prática?

    O foco do Spotify não é punir quem usa IA para mixar ou masterizar, mas sim dar transparência ao ouvinte sobre quem (ou o quê) ele está escutando. Veja os principais pontos da atualização:

    • Selo de identificação: Perfis de artistas fictícios, gerados inteiramente por máquina, receberão a marcação “AI Persona” visível para o público.
    • O Corte Algorítmico (O famoso Shadowban algorítmico): Contas com esse selo serão removidas, por padrão, das recomendações personalizadas (como o Discover Weekly) e das cobiçadas playlists editoriais. A música só ganhará plays se o ouvinte buscar ativamente pelo projeto ou decidir seguir o perfil fictício.
    • A Triagem: O Spotify abriu a opção para que os criadores declarem voluntariamente a natureza do projeto no painel do Spotify for Artists. Além disso, a plataforma usará revisão humana e ferramentas de detecção para auditar perfis, permitindo em breve que os próprios usuários denunciem contas que pareçam fakes.

    Transparência e a Frustração do Ouvinte

    A justificativa da empresa é simples: transparência. Muitos usuários relataram frustração ao se conectarem com uma música e uma imagem de aparência humana, para logo depois descobrirem que não havia ninguém do outro lado. Não havia história, não havia suor, não havia uma pessoa real por trás daquela arte.

    O que isso significa para o produtor moderno?

    Se você tem acompanhado o mercado e as aulas do nosso treinamento Produção Musical com I.A., sabe que nós sempre batemos na mesma tecla: a inteligência artificial é uma ferramenta poderosa, não um substituto para a sua identidade.

    Essa nova política do Spotify valida exatamente o modelo de produção híbrida. Você pode (e deve) usar tecnologias fantásticas como Suno para prototipar ideias, ferramentas de clonagem vocal para texturas e plugins com machine learning para acelerar sua mixagem no Reaper ou no Cubase. O que o Spotify está penalizando é a terceirização completa da arte e da identidade para a máquina.

    A tecnologia nos dá velocidade, mas a emoção e a composição humana continuam sendo insubstituíveis. É por isso que projetos focados no songwriting real e na energia de instrumentos físicos — exatamente a proposta de projetos de rock autoral, como venho desenvolvendo com o Maquinista Araujo — ganham ainda mais valor nesse novo cenário. O público quer se conectar com humanos.


    Conclusão

    O selo “AI Persona” não é o fim da linha para a inteligência artificial na música, mas sim um filtro de qualidade para a plataforma. É um alerta para quem achou que poderia inundar o streaming com perfis falsos e ficar rico com o algoritmo.

    Para nós, produtores de carne e osso, é uma excelente notícia. Use a IA para expandir seus limites técnicos, criar timbres impensáveis e agilizar seu fluxo de trabalho, mas mantenha a sua assinatura. No fim das contas, a sua humanidade é o seu maior diferencial no mercado.

    E você, o que achou dessa nova medida do Spotify? Acha que o algoritmo vai conseguir separar bem quem usa IA como ferramenta de quem cria personas fakes? Deixe sua opinião nos comentários!

  • Criei um Plugin JS Incrível: SomBinario VCA Punch

    Criei um Plugin JS Incrível: SomBinario VCA Punch

    O Fim dos Plugins Caros? Conheça o SomBinário VCA Punch

    Você já sofreu da Síndrome da Interface Bonita? É aquele fenômeno onde o nosso cérebro jura que um plugin de 200 dólares soa melhor do que um plugin gratuito, simplesmente porque ele tem uma renderização 3D realista com válvulas que brilham na tela.

    Eu estava cansado de ver produtores reféns dessa ilusão, focando mais nos gráficos do que na matemática do áudio. Foi por isso que eu decidi abrir a caixa preta do DSP (Processamento Digital de Sinais) e criar o compressor dos meus sonhos para o Mix Bus.

    Apresento a vocês o SomBinário VCA Punch: um plugin com visual direto ao ponto, leve para a CPU, mas com motores internos que batem de frente com os equipamentos mais lendários da indústria. E o melhor? Ele é 100% gratuito.

    Ou seja, leve e direto ao ponto. Sem códigos de segurança anti-pirataria, e animações inúteis, entre outras coisas que incham o plugin com coisas que o usuário final não precisa!

    Por que o VCA Punch soa tão analógico?

    O segredo de um bom compressor de Mix Bus (como os clássicos consoles britânicos) não está apenas em reduzir o volume, mas em como ele faz isso. Para chegar nesse nível, eu incorporei motores avançados no VCA Punch:

    • Crest Factor Híbrido (Peak vs RMS): Em vez de ser burro e esmagar qualquer pico, o cérebro do VCA Punch pode ler sinais de Pico (rápidos como uma navalha) e RMS (macios e musicais) ao mesmo tempo. Ajustando em 50%, você controla a caixa da bateria sem afundar a cama da música.
    • Modo DUAL (Auto-Release Inteligente): Um compressor comum causa “buracos” no som (pumping indesejado). O modo DUAL atua em dois estágios: ele solta o impacto inicial instantaneamente para proteger o groove, e depois segura o corpo do som de forma lenta e estável.
    • Controle THD (Total Harmonic Distortion): Adicione calor real! Ao subir o THD, o plugin injeta harmônicos pares e ímpares que trazem a agressividade dos transformadores analógicos para as guitarras, vocais e bateria.
    • Filtro Thrust (Tilt EQ na Detecção): Chega de graves afundando sua mix. Esse filtro protege as frequências sub-graves, forçando o compressor a focar na energia dos médios e agudos.

    Como baixar e instalar gratuitamente?

    Se você usa o REAPER, o processo leva menos de 1 minuto. O VCA Punch está disponível exclusivamente através do nosso repositório no ReaPack.

    Basta copiar o link oficial do nosso repositório (https://raw.githubusercontent.com/jorgebinario/sombinariostuff/main/index.xml), colar em Extensions > ReaPack > Import repositories e sincronizar!

    Assista ao vídeo completo no YouTube para ver o review prático desse monstro em ação na mixagem, e feche os olhos para confiar apenas na sua audição.

    Um abraço e boas mixagens,
    Jorge SomBinário

    🎯 Quer levar sua Mixagem ao nível profissional?

    Plugins que emulam analógicos são incríveis, mas são apenas ferramentas. Aprenda a dominar o processo completo de mixagem, a audição crítica e o tratamento dinâmico do básico ao extremo avançado.

    CONHECER O CURSO FM3.5

  • ReaAssist A Inteligência Artificial do REAPER é Surreal

    ReaAssist A Inteligência Artificial do REAPER é Surreal

    A Revolução do ReaAssist no REAPER: Por que ele esmaga o uso comum de I.A. na Produção Musical?

    A inteligência artificial na produção musical deixou de ser uma promessa futurista e se tornou uma ferramenta de sobrevivência para quem quer escala e velocidade no estúdio. No entanto, com a chegada do ReaAssist para o REAPER, uma discussão acalorada tomou conta dos fóruns e dos comentários no YouTube.

    Muitos produtores e curiosos têm afirmado: “Eu não preciso disso, é só abrir a aba do ChatGPT ou do Gemini no navegador, pedir o código e colar no DAW. É a mesma coisa.”

    A verdade nua e crua? Não, não é a mesma coisa. Nem de longe.

    Neste artigo, vamos dissecar o que torna o ReaAssist uma das inovações mais brutais já criadas para o ecossistema do REAPER e por que a abordagem de “copiar e colar do navegador” está mantendo você na idade da pedra do fluxo de trabalho.

    O Mito do “Coworker de Navegador” (Por que o ChatGPT não basta)

    Quando você abre um modelo de linguagem no navegador e pede um script Lua para o REAPER, você está conversando com uma IA “cega”. Ela conhece a API do REAPER, sabe programar, mas ela não faz ideia do que está acontecendo na sua tela.

    O grande trunfo do ReaAssist é ser Session-Aware (Consciente da Sessão). Ele vive nativamente dentro do DAW e lê os metadados do seu projeto em tempo real. Quando você envia um prompt pelo ReaAssist, ele não manda apenas o seu texto para a nuvem; ele envia um raio-x cirúrgico do seu projeto.

    • Ele sabe exatamente quais trilhas estão selecionadas, seus nomes e índices.
    • Ele lê a cadeia de plugins (FX Chains) e os parâmetros atuais de cada efeito.
    • Ele compreende as rotas, os barramentos, e a posição exata do cursor de edição.
    • Ele varre os GUIDs (identificadores únicos) de cada item de áudio ou MIDI.

    Tentar fazer isso pelo ChatGPT exigiria que você exportasse logs complexos de texto da sua sessão, colasse no chat, torcesse para a IA entender, pegasse o código gerado, abrisse a action list, criasse um script, colasse o código, salvasse e executasse. E se desse erro de sintaxe? O pesadelo do debug começaria. Com o ReaAssist, a integração é nativa, com Undo Blocks seguros e um Safety Scanner que impede o código de rodar comandos destrutivos no seu sistema operacional.

    🤖 Produção Musical e o Futuro: Inteligência Artificial

    Combinar o calor do hardware analógico com o poder de processamento moderno é incrível. Mas a Inteligência Artificial já está revolucionando como criamos, mixamos e masterizamos. Saia na frente e domine essas novas ferramentas hoje mesmo.

    VER O STUDIO I.A.

    Magia Negra no MIDI: Humanização e Padrões Complexos

    Programar bateria virtual ou sintetizadores com o mouse pode deixar a música estéril e mecânica. Fazer a humanização na mão — ajustando o velocity nota por nota e tirando levemente os ataques do grid — consome horas preciosas de produção.

    Com o ReaAssist, você seleciona o item MIDI, abre o terminal integrado e escreve:

    “Analise o item MIDI selecionado. Humanize os ataques empurrando as notas de forma aleatória entre -6 e +8 ticks, e aplique uma variação de velocity de +/- 12%, focando em acentuar o tempo forte do compasso.”

    Em milissegundos, o código é gerado e aplicado. Mas não para por aí. Você pode pedir criações generativas baseadas na matemática musical. Precisa de um padrão de chimbal (hi-hat) em tercinas que vai acelerando no final do compasso? O ReaAssist programa o script que injeta os eventos MIDI perfeitamente no Take ativo. O que antes exigiria profundo conhecimento de teoria aplicada à grade do DAW, agora é resolvido com um pedido em linguagem natural.

    Scripts Avançados e o Fim do Trabalho Braçal

    Todo engenheiro de mixagem sofre com o “Mix Prep”. Receber 50 trilhas cruas de um cliente com nomes como “Audio_01_final_nova” e ter que organizar, pintar, nomear e rotear para o Mix Template é desanimador.

    Através da I.A. contextual, o REAPER se transforma em um estúdio autogerenciável. Você pode carregar suas trilhas cruas e pedir:

    “Analise as trilhas selecionadas e seus nomes. Crie barramentos (folders) apropriados para Bateria, Baixo, Guitarras e Vozes, mova as trilhas para seus respectivos folders e ajuste o ganho de todos os itens de áudio (Take Volume) para que o pico máximo atinja -18dBFS.”

    Isso não é apenas um script de organização; é inteligência de engenharia de áudio aplicada em massa. Um clique e sua sessão inteira sofre um gain staging perfeito, roteada e pronta para a mixagem.

    🎯 Quer levar sua Mixagem ao nível profissional?

    Plugins que emulam analógicos são incríveis, mas são apenas ferramentas. Aprenda a dominar o processo completo de mixagem, a audição crítica e o tratamento dinâmico do básico ao extremo avançado.

    CONHECER O CURSO FM3.5

    Programando seus próprios Plugins (JSFX) em Segundos

    Se as funções nativas de edição e roteamento já não fossem suficientes, o verdadeiro trunfo do ReaAssist para os power users é o desenvolvimento de DSP (Processamento Digital de Sinais). O REAPER tem uma linguagem nativa poderosíssima para criação de efeitos chamada JSFX.

    Escrever um JSFX exige entender algoritmos de áudio, matemática complexa de buffers e programação gráfica. Agora, a barreira de entrada caiu para zero. Você pode literalmente digitar:

    “Crie um plugin JSFX: um Bus Compressor estéreo focado em ‘glue’ com controles de Threshold, Ratio, Attack, Release e um filtro High-Pass no detector interno. Inclua a seção @gfx desenhando um medidor visual de Gain Reduction.”

    A I.A. escreve o código completo e a arquitetura gráfica básica. Você salva, e imediatamente tem um processador de dinâmica customizado, levíssimo e nativo inserido na sua Master Bus, reagindo perfeitamente aos transientes da sua mix.

    O Veredito

    Desmerecer o ReaAssist comparando-o com simples consultas no ChatGPT é um erro de quem ainda não entendeu o conceito de integração. Quando a inteligência artificial ganha olhos e ouvidos dentro da sua engine de áudio, ela deixa de ser um “oráculo de texto” e se transforma no melhor engenheiro assistente que você poderia contratar para o seu estúdio.

    O foco não é fazer a I.A. criar a música por você, mas sim eliminar a fricção técnica. Enquanto a concorrência perde preciosos minutos clicando em menus, roteando canais e debugando códigos soltos, você já está focando no que realmente importa: a criatividade e a emoção da música.

    💻 Domine sua DAW Preferida

    Não importa se você vai rodar o VT-15 no Cubase, FL Studio ou Studio One. O que importa é ter um fluxo de trabalho rápido e sem interrupções. Escolha sua arma:

    Cubase Pro

    Ver Curso →

    FL Studio

    Ver Curso →

    Studio One

    Ver Curso →

  • O Fim da Gourmetização no Áudio: Por que os Plugins Gratuitos estão vencendo o Jogo

    O Fim da Gourmetização no Áudio: Por que os Plugins Gratuitos estão vencendo o Jogo

    Se você acompanha conteúdos sobre produção musical, já deve ter notado uma mudança drástica no ar. Recentemente, levantei uma lebre nas redes sociais que gerou um engajamento absurdo: “A velha guarda pira, mas a verdade é que plugins gratuitos e legais já entregam tudo. Acabou a era da gourmetização de plugin!”

    Não demorou para os defensores de ecossistemas fechados e DSPs caríssimos aparecerem. Mas contra fatos (e matemática), não há argumentos. Neste artigo, vamos destrinchar como a evolução do Processamento Digital de Sinais (DSP), o movimento open-source e as redes neurais transformaram o mercado, provando que hoje você não compra mais qualidade sonora, você compra, no máximo, fluxo de trabalho e interfaces bonitas.

    1. O Salto dos Algoritmos DSP: A Eficiência do Código Aberto

    Há dez anos, justificar o preço de um plugin premium era fácil. O processamento nativo dos computadores era limitado, e as grandes marcas possuíam os melhores algoritmos para lidar com problemas complexos como o aliasing (a distorção desagradável gerada quando frequências ultrapassam o Limite de Nyquist no mundo digital).

    Hoje, o jogo virou. O acesso democratizado a linguagens e frameworks de desenvolvimento de áudio, como o JUCE (C++), permitiu que desenvolvedores independentes criassem motores de áudio incrivelmente robustos.

    Veja o caso da Tokyo Dawn Records (TDR). Os compressores e equalizadores gratuitos deles utilizam algoritmos de oversampling dinâmico e processamento vetorial de altíssima precisão. Outro gigante independente é a Analog Obsession, que entrega emulações analógicas (muitas vezes superiores a marcas de renome) de forma totalmente gratuita via Patreon.

    2. Inteligência Artificial e Redes Neurais: A Mudança de Paradigma

    Se o código aberto já incomodava a velha guarda, o Machine Learning veio para chutar a porta. A forma tradicional de emular um hardware analógico envolve engenharia reversa de circuitos, modelando matematicamente cada resistor, válvula e capacitor. Isso exige equipes enormes e milhões em Pesquisa e Desenvolvimento (P&D).

    As redes neurais, por outro lado, ignoram o circuito e focam apenas no comportamento. O algoritmo “escuta” o sinal de entrada e o sinal de saída do hardware original, aprendendo e recriando a resposta não-linear de saturação, distorção de fase e dinâmica com perfeição milimétrica.

    Ferramentas revolucionárias e de código aberto como o NAM (Neural Amp Modeler) permitem que a própria comunidade clone amplificadores e pedais lendários e os distribua de graça na internet. Essa quebra de barreira técnica é um dos focos fundamentais do nosso treinamento Produção Musical com I.A., onde mergulhamos nas emulações neurais e na integração dessas novas tecnologias no workflow de mixagem, mostrando que a inteligência artificial já não é o futuro, é a ferramenta que está na sua cara agora mesmo.

    3. A Síndrome da Interface Bonita (O Efeito Placebo)

    Aqui entramos na ferida mais dolorosa: a psicoacústica. O cérebro humano é facilmente enganado. Quando você abre um plugin pago que custa centenas de dólares, com uma interface gráfica 3D fotorrealista que simula parafusos desgastados e luzes de válvulas reagindo ao som, você quer ouvir a diferença. E o seu cérebro faz você ouvir.

    A indústria sabe disso e investe pesado em UI/UX (Design de Interface). Porém, quando fazemos testes cegos rigorosos, ouvindo o material através de fones analíticos e neutros, sem olhar para a tela, a maioria dos produtores veteranos não consegue distinguir o plugin premium do plugin gratuito de código aberto desenvolvido por um jovem talento independente.

    Para entender melhor como nosso cérebro pode ser facilmente “hackeado” pela visão, confira este vídeo sensacional sobre ilusões de áudio. Ele demonstra de forma prática como a nossa percepção visual altera diretamente o que acreditamos estar ouvindo:


    A indústria sabe disso e investe pesado em UI/UX (Design de Interface). Porém, quando fazemos testes cegos rigorosos, ouvindo o material através de fones analíticos e neutros, sem olhar para a tela, a maioria dos produtores veteranos não consegue distinguir o plugin premium do plugin gratuito de código aberto desenvolvido por um jovem talento independente.

    4. Conclusão: Onde Investir Seu Dinheiro Hoje?

    Pagar por plugins deixou de ser uma regra absoluta para alcançar qualidade de rádio. Hoje, você investe dinheiro em plugins pelos seguintes motivos:

    • Fluxo de Trabalho (Workflow): Você paga para girar um botão em vez de três. Ferramentas que economizam tempo valem o investimento em um estúdio comercial.
    • Suporte Técnico e Estabilidade: Garantia de que a ferramenta não vai causar instabilidade na sua DAW no meio de uma sessão crítica, e que terá atualizações consistentes.
    • Ecossistema: Integração com hardwares específicos e controladores nativos.

    A “gourmetização” do áudio está perdendo força. A barreira de entrada para a excelência sonora nunca foi tão baixa. A pergunta que fica é: você está tirando o máximo das ferramentas que já tem à sua disposição, ou ainda está esperando o próximo plugin mágico em promoção para salvar sua mix?

  • Por que sua mix soa fraca perto das referências?

    Por que sua mix soa fraca perto das referências?

    Por que a sua música soa fraca ao lado de grandes lançamentos?

    Vou te confessar uma coisa que pouca gente no mercado de produção musical gosta de admitir abertamente.

    Anos atrás, eu passava noites em claro no estúdio trabalhando em uma mixagem. Eu ajustava cada detalhe, limpava as pistas, exportava e achava que o trabalho estava incrível. Mas o balde de água fria vinha logo em seguida.

    Bastava eu colocar a minha música para tocar em uma playlist, logo depois de um grande lançamento comercial, para sentir aquela frustração gigante. Minha música parecia despencar de volume. Ela soava pequena, magra e sem aquele impacto na região dos graves que faz o peito tremer.

    Batia um desespero silencioso. Eu me cobrava demais. Achava que o problema era o meu ambiente, que eu não tinha os compressores analógicos caros, ou que precisava de um limiter mágico de milhares de dólares.

    Para tentar compensar, eu fazia o que a maioria faz: começava a esmagar o limiter no canal master. O resultado? A música distorcia, perdia toda a dinâmica, os transientes sumiam e, bizarramente, ela continuava soando fraca.

    Foi só quando parei de procurar truques rápidos e decidi me aprofundar na física do som que a chave virou.


    O Loudness Competitivo é Pura Física do Som

    Percebi que o loudness não é construído na etapa final com um limiter. Ele é o resultado direto de um fluxo de sinal inteligente. Abaixo, separei os três pilares que vão fazer a sua Mixagem soar competitiva sem perder a vida.

    1. Controle a Fase dos Graves (Não use apenas o EQ)

    Frequências graves desalinhadas causam cancelamento de fase e engolem o seu headroom inteiro. Se o bumbo e o baixo estão brigando, você não vai resolver isso girando botões de equalizador para cima. Você precisa alinhar fisicamente o bumbo e o baixo no tempo para que os transientes se somem. O alinhamento de fase é o que garante o soco no peito sem roubar espaço na sua via principal.

    🎯 Quer levar sua Mixagem ao nível profissional?

    Plugins que emulam analógicos são incríveis, mas são apenas ferramentas. Aprenda a dominar o processo completo de mixagem, a audição crítica e o tratamento dinâmico do básico ao extremo avançado.

    CONHECER O CURSO FM3.5

    2. Distribua o Ganho e Use Clippers

    Pare de esmagar o seu limiter no master. O segredo dos profissionais é distribuir esse ganho ao longo do caminho. Use ferramentas de soft clipping nos subgrupos (como no grupo de bateria, por exemplo) para raspar os picos dos transientes. O soft clipping adiciona densidade harmônica e aumenta o volume percebido pela física do som. Você ganha volume agressivo antes mesmo do áudio chegar na sua master.

    💻 Domine sua DAW Preferida

    Não importa se você vai rodar o VT-15 no Cubase, FL Studio ou Studio One. O que importa é ter um fluxo de trabalho rápido e sem interrupções. Escolha sua arma:

    Cubase Pro

    Ver Curso →

    FL Studio

    Ver Curso →

    Studio One

    Ver Curso →

    3. Domine as Ressonâncias (Limpe a “Lama”)

    Um acúmulo na região dos médios-graves consome uma energia invisível gigantesca. Limpe essa lama entre 150 e 400 hertz com cortes precisos. Usar um equalizador dinâmico para agir apenas quando essa região acumula demais é uma técnica excelente. Isso libera espaço vital no seu fluxo de sinal para a música respirar e, consequentemente, soar muito mais alta e clara no final.

    🤖 Produção Musical e o Futuro: Inteligência Artificial

    Combinar o calor do hardware analógico com o poder de processamento moderno é incrível. Mas a Inteligência Artificial já está revolucionando como criamos, mixamos e masterizamos. Saia na frente e domine essas novas ferramentas hoje mesmo.

    VER O STUDIO I.A.


  • Seu Beat Soa “De Plástico”? Como Criar Movimento e Vida na sua Produção

    Seu Beat Soa “De Plástico”? Como Criar Movimento e Vida na sua Produção

    Mais movimento para suas produções

    Sabe aquela sensação de terminar uma produção, dar o play e sentir que tudo soa meio… robótico? Um loop de oito compassos que cansa o ouvido em apenas dez segundos, parecendo que saiu direto de uma fôrma de plástico estática. Se você já passou por isso, saiba que a culpa não é dos seus samples ou dos seus sintetizadores. A culpa é da falta de movimento.

    Na música profissional, nada fica parado. O segredo das grandes mixagens e produções que colam no ouvido do ouvinte é a evolução constante dos elementos. Abaixo, assista ao nosso Reels rápido resumindo o conceito e, em seguida, aprofunde-se nos 5 passos práticos com o nosso mega arsenal de plugins gratuitos!

    🎬 Assista ao Vídeo Rápido:

    Veja as técnicas de movimento aplicadas diretamente na DAW.

    ME SIGA NO INSTAGRAM!

    A Importância do Movimento na Produção Musical

    Quando o cérebro humano escuta um som repetitivo que não muda em nada ao longo do tempo (seja em volume, timbre ou posição no espaço), ele ativa um mecanismo chamado habituação. O cérebro simplesmente ignora aquele som porque ele se tornou previsível. Para manter o ouvinte conectado, você precisa criar nuances que simulem a performance de um instrumentista real ou a acústica de um ambiente vivo.

    5 Dicas Práticas para Injetar Vida nas suas Tracks

    1. Arranque a Quantização Perfeita (Micro-timing)

    O “Snap to Grid” (ajuste à grade) é ótimo para organizar as ideias, mas destrói o balanço natural. Desative a grade da sua DAW e puxe ligeiramente as caixas (claps/snares) alguns milissegundos para trás do tempo para dar uma sensação mais “relaxada” (laid-back). Use também a função Randomize Velocity nos hi-hats; variações dinâmicas sutis fazem o groove respirar como se fosse tocado por um baterista humano.

    2. Automação de Filtro (LFO)

    Um acorde longo de sintetizador (Pad) ou até uma linha de baixo podem soar monótonos muito rápido. A solução é usar um LFO (Low-Frequency Oscillator) lento, configurado para 2 ou 4 compassos, modulando o Cutoff do filtro. O som estático instantaneamente se transforma em uma textura evolutiva que pulsa em perfeita sincronia com o arranjo.

    3. Ducking Fantasma (Sidechain Ativo)

    O Sidechain vai muito além de abrir espaço para o bumbo passar na mixagem. Ele funciona como uma ferramenta incrível de balanço rítmico. Você pode usar o Kick para acionar o compressor de um contrabaixo ou de um sintetizador, criando aquele “bombeio” clássico. Se quiser um controle ainda mais desenhado, utilize plugins dedicados a criar curvas de volume contínuas para moldar o groove.

    4. O Efeito Gate

    Pegue uma nota ou acorde longo e contínuo (Sustain) e jogue um efeito de Trance Gate ou desenhe automações rítmicas agressivas de volume usando ondas quadradas (Square) ou dentes de serra (Sawtooth) na DAW. Um som reto e tedioso se transforma imediatamente em um arpejo percussivo na hora.

    5. Automação Espacial na Mixagem

    O campo estéreo é o seu playground. Desenhe curvas de automação de Panning para fazer as percussões passearem de um lado para o outro dos fones de ouvido. Aproveite também o final das frases de voz ou instrumentos principais para automatizar a mandada (Send) de um Reverb ou Delay, preenchendo os vazios de forma tridimensional.

    O Mega Arsenal do Movimento: A Lista Definitiva de Plugins Gratuitos

    Fizemos um garimpo profundo pela internet para trazer as ferramentas mais insanas (e gratuitas) para você colocar essas técnicas em prática. Salve esta página nos seus favoritos, pois esse é o seu novo kit de sobrevivência para dar vida às suas mixagens:

    1. Flux Mini 2

    Desenvolvedor: Caelum Audio

    Um plugin espetacular que permite desenhar formas de onda personalizadas para modular filtros e volume. É perfeito tanto para criar efeitos de ducking/sidechain precisos quanto para adicionar modulações rítmicas complexas em pads e loops.

    Baixar Oficial

    2. STFU

    Desenvolvedor: Zeek

    Um concorrente de peso (e gratuito) para plugins pagos de automação de volume. Ele sincroniza perfeitamente com o BPM da sua DAW e permite desenhar curvas de volume cirúrgicas. Excelente para sidechain pumping ou para picotar synths criando grooves frenéticos.

    Baixar Oficial

    3. PanCake 2

    Desenvolvedor: Cableguys

    O rei absoluto do panning gratuito. Com ele, você desenha de forma visual como o som vai navegar entre as caixas (esquerda/direita) sincronizado ao BPM. Essencial para dar movimento tridimensional a hi-hats, shakers e texturas.

    Baixar Oficial

    4. MAutoPan

    Desenvolvedor: MeldaProduction

    Parte do excelente bundle gratuito da Melda. Mais do que um simples panner, ele possui LFOs incrivelmente avançados que podem modular não só a posição no panorama, mas gerar efeitos de tremolo ricos para guitarras e pianos elétricos.

    Baixar Oficial

    5. TAL-Filter-2

    Desenvolvedor: TAL Software

    Um clássico focado em modulação. Ele oferece filtros de alta qualidade controlados por um gráfico de LFO sincronizado com a DAW. Uma das melhores ferramentas para transformar sons estáticos em pulsações evolutivas no arranjo.

    Baixar Oficial

    6. A1TriggerGate

    Desenvolvedor: Alex Hilton

    Se você quer aquele efeito de “Trance Gate” que pica e fatia o som de forma sequenciada e rítmica, esse plugin é a escolha ideal. Ele conta com um step-sequencer integrado para desenhar texturas complexas em cima de pads lisos e guitarras estáticas.

    Baixar Oficial

    7. Ozone Imager V2

    Desenvolvedor: iZotope

    Quer dar movimento espacial abrindo a imagem estéreo sem destruir a correlação de fase? O Ozone Imager é de altíssima qualidade. Você pode automatizar a largura estéreo ao longo da track (ex: abrir mais no refrão para dar a sensação de expansão e explosão).

    Baixar Oficial

    8. Wider

    Desenvolvedor: Polyverse Music

    Se você quer alargar sons mono sem perder punch quando a música tocar em caixinhas mono (celular, por exemplo), o Wider é mágico. Use em automações de builds e drops para criar aquele movimento que “abraça” o ouvinte.

    Baixar Oficial

    9. Hysteresis

    Desenvolvedor: Glitchmachines

    Para quem quer um movimento mais caótico e moderno. É um efeito de delay com stutter (glitch) e modulação voltado para sound design agressivo. Se sua bateria eletrônica está sem graça, passe ela pelo Hysteresis e assista a mágica robótica e imprevisível acontecer.

    Baixar Oficial

    10. DLYM (Delay Modulator)

    Desenvolvedor: Imaginando

    Um efeito de chorus e flanger gratuito absurdo para criar profundidade e movimento. Se o seu baixo synth ou os seus vocais de apoio estiverem finos ou parados, a modulação de tempo do DLYM vai trazer textura e oscilação orgânica no estéreo.

    Baixar Oficial

    11. TDR Nova

    Desenvolvedor: Tokyo Dawn Labs

    Um equalizador dinâmico paralelo extremamente poderoso. Perfeito para fazer o “Ducking Fantasma” cirúrgico: use a entrada de sidechain externa para abaixar apenas frequências específicas (como a região dos graves do baixo quando o bumbo bate), gerando clareza e movimento sutil.

    Baixar Oficial


    Aprenda mais!

    E se você quer dar o próximo passo na sua jornada musical, dominar o áudio de ponta a ponta e aprender a usar suas ferramentas de mixagem e síntese como um verdadeiro profissional, não perca tempo: clique aqui para conhecer os cursos completos de Produção Musical, Sound Design e Mixagem do SomBinário.

  • Acustica Audio ASH 2 – Muito Além do Clipping

    Acustica Audio ASH 2 – Muito Além do Clipping

    O Segredo dos Conversores High-End: Descubra os Equipamentos por Trás do ASH 2

    Se você procura alcançar aquele nível de loudness comercial competitivo sem amassar os seus transientes ou destruir a profundidade da sua mixagem, a clipagem (clipping) é uma etapa obrigatória. E a nova versão do ASH 2 da Acustica Audio elevou esse jogo a um patamar insano, trazendo o som dos conversores analógicos mais cobiçados do mundo diretamente para dentro do seu estúdio.

    A Magia Híbrida: O Motor N.O.V.A.

    O grande diferencial do ASH 2 não é apenas cortar os picos. Ele utiliza uma tecnologia chamada N.O.V.A. (Neural Optimized Volterra Audio), que combina a precisão da amostragem (kernels de Volterra) com o comportamento não-linear das redes neurais. Isso significa que, antes mesmo de clipar, o áudio passa por um estágio de pré-amplificação fiel ao hardware original. Cada módulo reage dinamicamente, engordando o som e adicionando riqueza harmônica conforme você empurra o sinal.

    🎯 Quer levar sua Mixagem ao nível profissional?

    Plugins que emulam analógicos são incríveis, mas são apenas ferramentas. Aprenda a dominar o processo completo de mixagem, a audição crítica e o tratamento dinâmico do básico ao extremo avançado.

    CONHECER O CURSO FM3.5

    Mapeando o DNA Sonoro: Burl, Lavry e o Circuito Neon

    Por questões de direitos autorais, a Acustica Audio não divulga os nomes dos aparelhos emulados, mas a comunidade de engenharia de áudio já fez os testes e revelou os segredos:

    • 🟡 Família Yellow (O Peso): Aponta diretamente para o icônico Burl Audio B2 Bomber ADC. É a sua escolha quando você precisa de peso, corpo e aquela saturação orgânica de transformador para engrossar baterias e sintetizadores.
    • Família Gray (A Transparência): Baseado no lendário Lavry Gold AD122-96. O padrão-ouro da masterização moderna. Use a família Gray quando quiser um gerenciamento de picos cirúrgico e transparente, elevando o RMS sem colorir o áudio original.
    • 💡 Stedal Neon (O Caos Controlado): Uma das opções mais exóticas. Baseado num circuito homebrew customizado que utiliza uma lâmpada de néon real para clipar o som de forma drástica e texturizada, gerando um efeito agressivo perfeito para paralelos e fuzz.

    💻 Domine sua DAW Preferida

    Não importa se você vai rodar o ASH 2 no Cubase, FL Studio ou Studio One. O que importa é ter um fluxo de trabalho rápido e sem interrupções. Escolha sua arma:

    Cubase Pro

    Ver Curso →

    FL Studio

    Ver Curso →

    Studio One

    Ver Curso →

    Expandindo o Arsenal

    Além destes, o ASH 2 ainda conta com emulações suspeitas de serem da Apogee e Prism Sound nas linhas Onyx e Platinum, sem falar nas novidades exclusivas da versão 2: os modelos Bole e Fawn, que prometem ainda mais texturas baseadas em circuitos de saturação densa e ótica.

    Na hora de masterizar, testar a diferença entre o comportamento analógico e macio da família Yellow e o controle cristalino da linha Gray pode ser o fator decisivo para a profundidade final do seu lançamento.

    🤖 Produção Musical e o Futuro: Inteligência Artificial

    Combinar o calor do hardware analógico com o poder de processamento neural é incrível. Mas a Inteligência Artificial já está revolucionando de forma ampla como criamos, mixamos e masterizamos. Saia na frente e domine essas novas ferramentas hoje mesmo.

    VER O CURSO PRODUÇÃO MUSICAL COM I.A.